
Você arruma um detalhe no código, roda os testes e tudo passa. Horas depois, o cliente liga reclamando de um erro num módulo que ninguém tocou. Você abre o histórico de commits e descobre: uma dependência desatualizada, uma variável mal nomeada, um esquecimento. Tudo passou porque a revisão manual não cobriu.
Esse cenário é comum. Você não está sozinho. A revisão humana é essencial, mas ela tem limites de velocidade, atenção e consistência. Existe uma camada de verificação que roda junto com o código e pega esses defeitos antes do merge. O desafio não é ligar tudo, é escolher o que ligar primeiro.
Muita gente tem medo de automatizar e acabar com o pipeline travado ou uma enxurrada de avisos que ninguém lê. A revisão automática não veio para substituir seu julgamento. Ela veio para tirar o ruído da sua frente e deixar o risco real mais visível.
Eu costumo ver isso acontecer com frequência em times pequenos: a automação assusta porque parece complexa, mas o erro é sempre de calibragem, não de tecnologia.
- Revisão automática de código é o conjunto de verificações executadas por máquinas sobre o código-fonte, o diff de um pull request ou o artefato gerado, sem leitura humana linha por linha.
- Ela inclui linters, análise estática de segurança, análise de dependências, verificação de credenciais expostas e infraestrutura como código, além de agentes de IA que leem o contexto do repositório.
- Equipes gastam entre 15% e 30% do tempo de desenvolvimento revisando código de colegas, e boa parte desse tempo é consumida por itens que uma máquina resolveria, como espaçamento e imports órfãos.
- A LGPD prevê sanção de até 2% do faturamento da empresa no Brasil, limitada a R$ 50 milhões por infração, o que impulsiona a verificação automática de credenciais e de dependências vulneráveis.
- A revisão automática não substitui a revisão humana; ela reduz o ruído e entrega ao revisor um diff já limpo de erros triviais, sem poder de aprovar ou bloquear o merge na maioria das configurações.
- O que automatizar primeiro quando o time é pequeno e o projeto já está no ar?
- Como separar linter, análise estática, dependências e IA para montar um fluxo que não trava o pipeline.
- Um roteiro de duas semanas para implantar revisão automática com ajuste gradual de severidade e sem afogar o time em avisos.
Revisar código manualmente cansa, mas ignorar a máquina custa caro
Você já passou horas olhando um diff e achou algo que a máquina teria pego em segundos. Ou pior: deixou passar um erro porque estava cansado. A revisão por pares é insubstituível para arquitetura e decisões de negócio, mas é péssima para tarefas repetitivas.
Na prática, eu vejo revisores desperdiçando horas com coisas que um linter resolve em segundos. O que pouca gente percebe é que a revisão automática não é uma coisa só. Existem camadas diferentes, cada uma com um tipo de retorno. Um linter pega estilo e erros de sintaxe. Um analisador de segurança pega injeção de código. Um verificador de credenciais pega token exposto. Tudo isso roda no mesmo fluxo, mas com propósitos distintos.
Comece com um linter e um verificador de credenciais. Eles resolvem a maior parte do ruído e não exigem curva de aprendizado para o time acostumar.
Revisão automatizada de código é o nome dado ao conjunto de verificações que rodam sobre o código-fonte, o diff de um pull request ou merge request, sem que um humano leia linha por linha. Essas verificações podem acontecer em vários momentos: antes do commit, na abertura do PR, em rodadas noturnas ou dentro do pipeline de CI/CD.
Para que serve? Para pegar defeito cedo, reduzir retrabalho e liberar o olhar humano para as decisões que a máquina não pode tomar. Um erro de digitação pego no editor custa segundos; o mesmo erro achado em produção custa horas de plantão, comunicação com clientes e rollback. Eu gosto de pensar nisso como um filtro que deixa o revisor olhar só para as decisões difíceis.
Por que existe? Nasceu com os compiladores, que já apontavam erros de sintaxe. Depois vieram os linters, a análise estática corporativa e, mais recentemente, agentes de IA. A lógica sempre foi a mesma: quanto mais cedo um defeito é encontrado, mais barato ele é.
Como é utilizado? No fluxo de versionamento, geralmente como um quality gate. O código sobe, a revisão automática roda, e se a severidade dos alertas passar do limite, o merge é bloqueado ou o time é avisado. Mas a maioria das configurações não bloqueia sozinha: ela reduz o ruído e entrega um diff limpo para o revisor humano.
Principais características incluem:
- Execução automática com gatilhos definidos, como abertura de PR ou push em branch específica.
- Múltiplas camadas de análise: estilo, bugs, segurança, dependências, credenciais expostas e infraestrutura.
- Personalização por arquivo de política versionado no repositório, com severidade e pastas ignoradas.
- Capacidade de sugerir correção aplicável com um clique, reduzindo o tempo de correção.
- Integração com plataformas de versionamento e pipelines existentes.
Benefícios: menos tempo de revisão manual, consistência na aplicação de padrões, detecção precoce de vulnerabilidades, conformidade com normas como OWASP Top 10 e NIST SSDF, e redução da dívida técnica.
Eu já vi time desistir da automação porque configurou tudo de uma vez e o pipeline passou a levar vinte minutos. O erro não foi a ferramenta, foi a ordem de ativação. Primeiro se resolve o que dói mais: estilo e credenciais. Depois segurança e dependências. IA por último, quando a equipe já confia no básico.
Dicas práticas para aproveitar revisão automática de código no dia a dia
O primeiro passo é aceitar uma limitação: a máquina nunca decide sozinha sobre arquitetura, legibilidade de negócio ou experiência do usuário. Ela aponta, você decide. O famoso human-in-the-loop é o princípio central.
Outra dúvida comum é sobre projeto legado. Funciona, mas não espere acender tudo de uma vez. O código antigo vai gerar centenas de alertas. A saída é congelar a régua atual e só aplicar novas regras em código novo. Caso contrário, o time morre afogado em ruído.
Curiosidade histórica: a inspeção formal de código no estilo Fagan, criada na década de 70, já previa papéis definidos e checklist. A automação não é uma invenção recente, é a evolução natural daquela intenção. O que mudou foi a velocidade e a cobertura.
Mitos comuns: automatizar revisão não deixa o código perfeito. Não elimina a necessidade de testes. Não garante segurança total. E não resolve problema de cultura do time que ignora alerta.
Erros comuns e como evitá-los
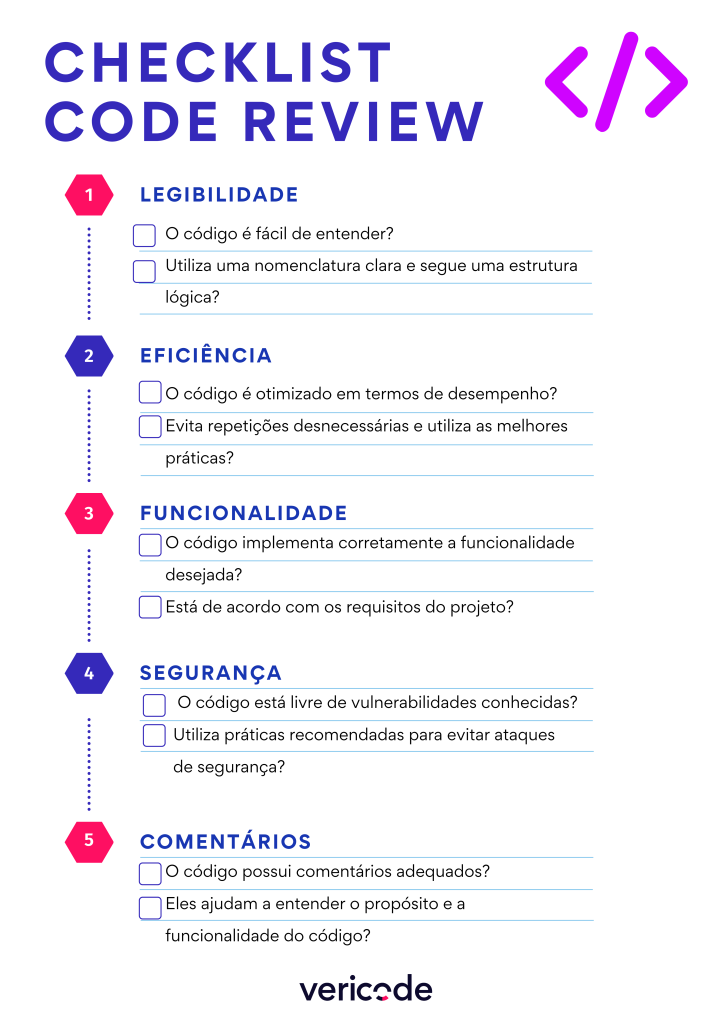
Na minha experiência, o erro de ligar todas as camadas de uma vez é o mais frequente. A lista abaixo reúne os tropeços que vejo com mais regularidade.
- Ligar todas as camadas de uma vez sem calibragem. Evite: comece com linter, formatador e verificador de credenciais.
- Configurar SAST com severidade padrão e esperar que o time leia tudo. Evite: suba o limite de severidade e foque em regras críticas no início.
- Ignorar o tempo de execução do pipeline. Evite: meça o tempo de cada análise e mova as mais lentas para rodadas noturnas.
- Não versionar o arquivo de política. Evite: coloque a régua de revisão no repositório, no branch base, para que ninguém altere sem aprovação.
- Deixar a IA revisar sem etapa de verificação de achados. Evite: prefira agentes que filtram contra o comportamento real do código e exigem revisão humana.
Se o time começa a ignorar alertas, não é preguiça. É excesso de falso positivo. Ajuste a severidade, não a equipe.
Um roteiro de duas semanas que não trava seu time
Guia Rápido · Pontos-Chave
- 01A Escolha Certa: Comece com linter, formatador e verificador de credenciais. Essas três camadas entregam o maior ganho com menor ruído e funcionam em qualquer projeto, mesmo legado.
- 02Ponto de Atenção: Não aumente a severidade de regras de segurança antes de calibrar os falsos positivos. Um SAST mal ajustado gera alertas demais e o time passa a ignorar tudo.
- 03Na Prática: Crie um arquivo de política versionado no repositório que defina severidade, arquivos ignorados e limite de tempo. Rode a primeira varredura só em modo comentário, sem bloquear merge.
O que pouca gente percebe é que a automação não é um interruptor: é um quadro de três colunas. O que automatizar agora, o que automatizar depois e o que nunca automatizar. Esse cruzamento com o tamanho do time evita o cenário de alerta em excesso e mantém a confiança no processo.
Eu recomendo fortemente medir o tempo de cada análise antes de adicionar outra camada. A revisão automática não é um bicho de sete cabeças nem uma bala de prata. Ela é uma camada que tira da sua frente os erros que consomem tempo e deixa o olhar humano para o que importa. Se o fluxo estiver bem calibrado, você ganha velocidade sem perder qualidade.
Pegue um pull request aberto agora. Rode um linter e um verificador de credenciais nele. Anote quantos avisos apareceram e quantos eram reais. Esse número vai dizer se sua régua está boa ou se precisa de ajuste. A ação é simples e o retorno é imediato.
Automatize o que é repetitivo. Revise o que exige julgamento. A máquina caça, você decide.
