
Você abre a documentação e vê endpoint de agente autônomo, function calling, conversation_id e uma vontade imediata de fechar a aba. Parece chat, mas não é.
A API de agente não devolve a próxima palavra. Ela executa um ciclo. Decide quais ferramentas chamar, observa o resultado e itera até concluir a tarefa. É um contrato com um runtime, não com um modelo de texto. E isso muda cada decisão de arquitetura, custo e segurança.
A escolha errada custa semanas. O texto não é mais um tutorial de ‘como fazer’. É um mapa para entender o que cada parte da API faz, qual rota escolher conforme o tamanho do projeto e quais erros evitar antes de colocar no ar. Você não precisa de mais uma demonstração. Precisa entender o contrato.
Minha experiência: quando o time entende que a API não é um endpoint de texto, metade das decisões de arquitetura fica óbvia. O problema é que a documentação raramente deixa isso claro.
- API de agentes é a interface programática que permite criar, configurar e executar um agente de IA, expondo endpoints para registro do agente, prompt versionado, ferramentas e sessões.
- Diferente de um endpoint de chat, a chamada aciona um ciclo perceber-planejar-agir-observar: o modelo decide quando chamar ferramentas declaradas em JSON Schema e itera até concluir a tarefa.
- Existem três rotas principais: SDK de provedor de modelo (ex.: OpenAI Agents SDK, Gemini API), framework de código aberto com servidor próprio (LangGraph, CrewAI, n8n) e plataforma gerenciada com sandbox remoto.
- O custo de um agente é medido em tokens, não em chamadas; um agente que encadeia cinco ferramentas consome de três a dez vezes mais tokens do que um chatbot de uma pergunta.
- Antes de produção, é obrigatório definir limite de passos, timeout por ferramenta, idempotência, versionamento de prompt, guardrails, tracing e teto de tokens por sessão.
- O que muda de verdade quando o endpoint deixa de completar texto e passa a executar um runtime com ferramentas.
- Os endpoints essenciais, a autenticação e as permissões que evitam brechas de segurança em produção.
- Como comparar plataforma gerenciada, framework de código aberto e low-code sem cair em dependência cara.
- O checklist de pré-produção que revela o sintoma de cada configuração ausente.
O contrato invisível por trás de uma chamada que parece simples
Uma chamada de API parece inofensiva. Mas quando o agente entra no loop, cada turno pode acionar ferramentas, buscar dados em sistemas internos e gravar estado. Tudo isso consome tokens e tempo. E o custo aparece depois, no fim do mês.
A diferença entre um assistente que funciona e um que frustra está em detalhes que a documentação nem sempre mostra. O versionamento do prompt, o limite de passos, o timeout das ferramentas externas, a política de segurança de cada endpoint. Ignorar essas camadas é o caminho mais rápido para reescrever tudo no mês seguinte.
Dica prática: antes de escolher uma API, liste as ferramentas que o agente vai chamar. O gargalo quase nunca está no modelo, e sim na latência dessas integrações externas.
API de agentes: o contrato entre seu sistema e um runtime que decide e executa
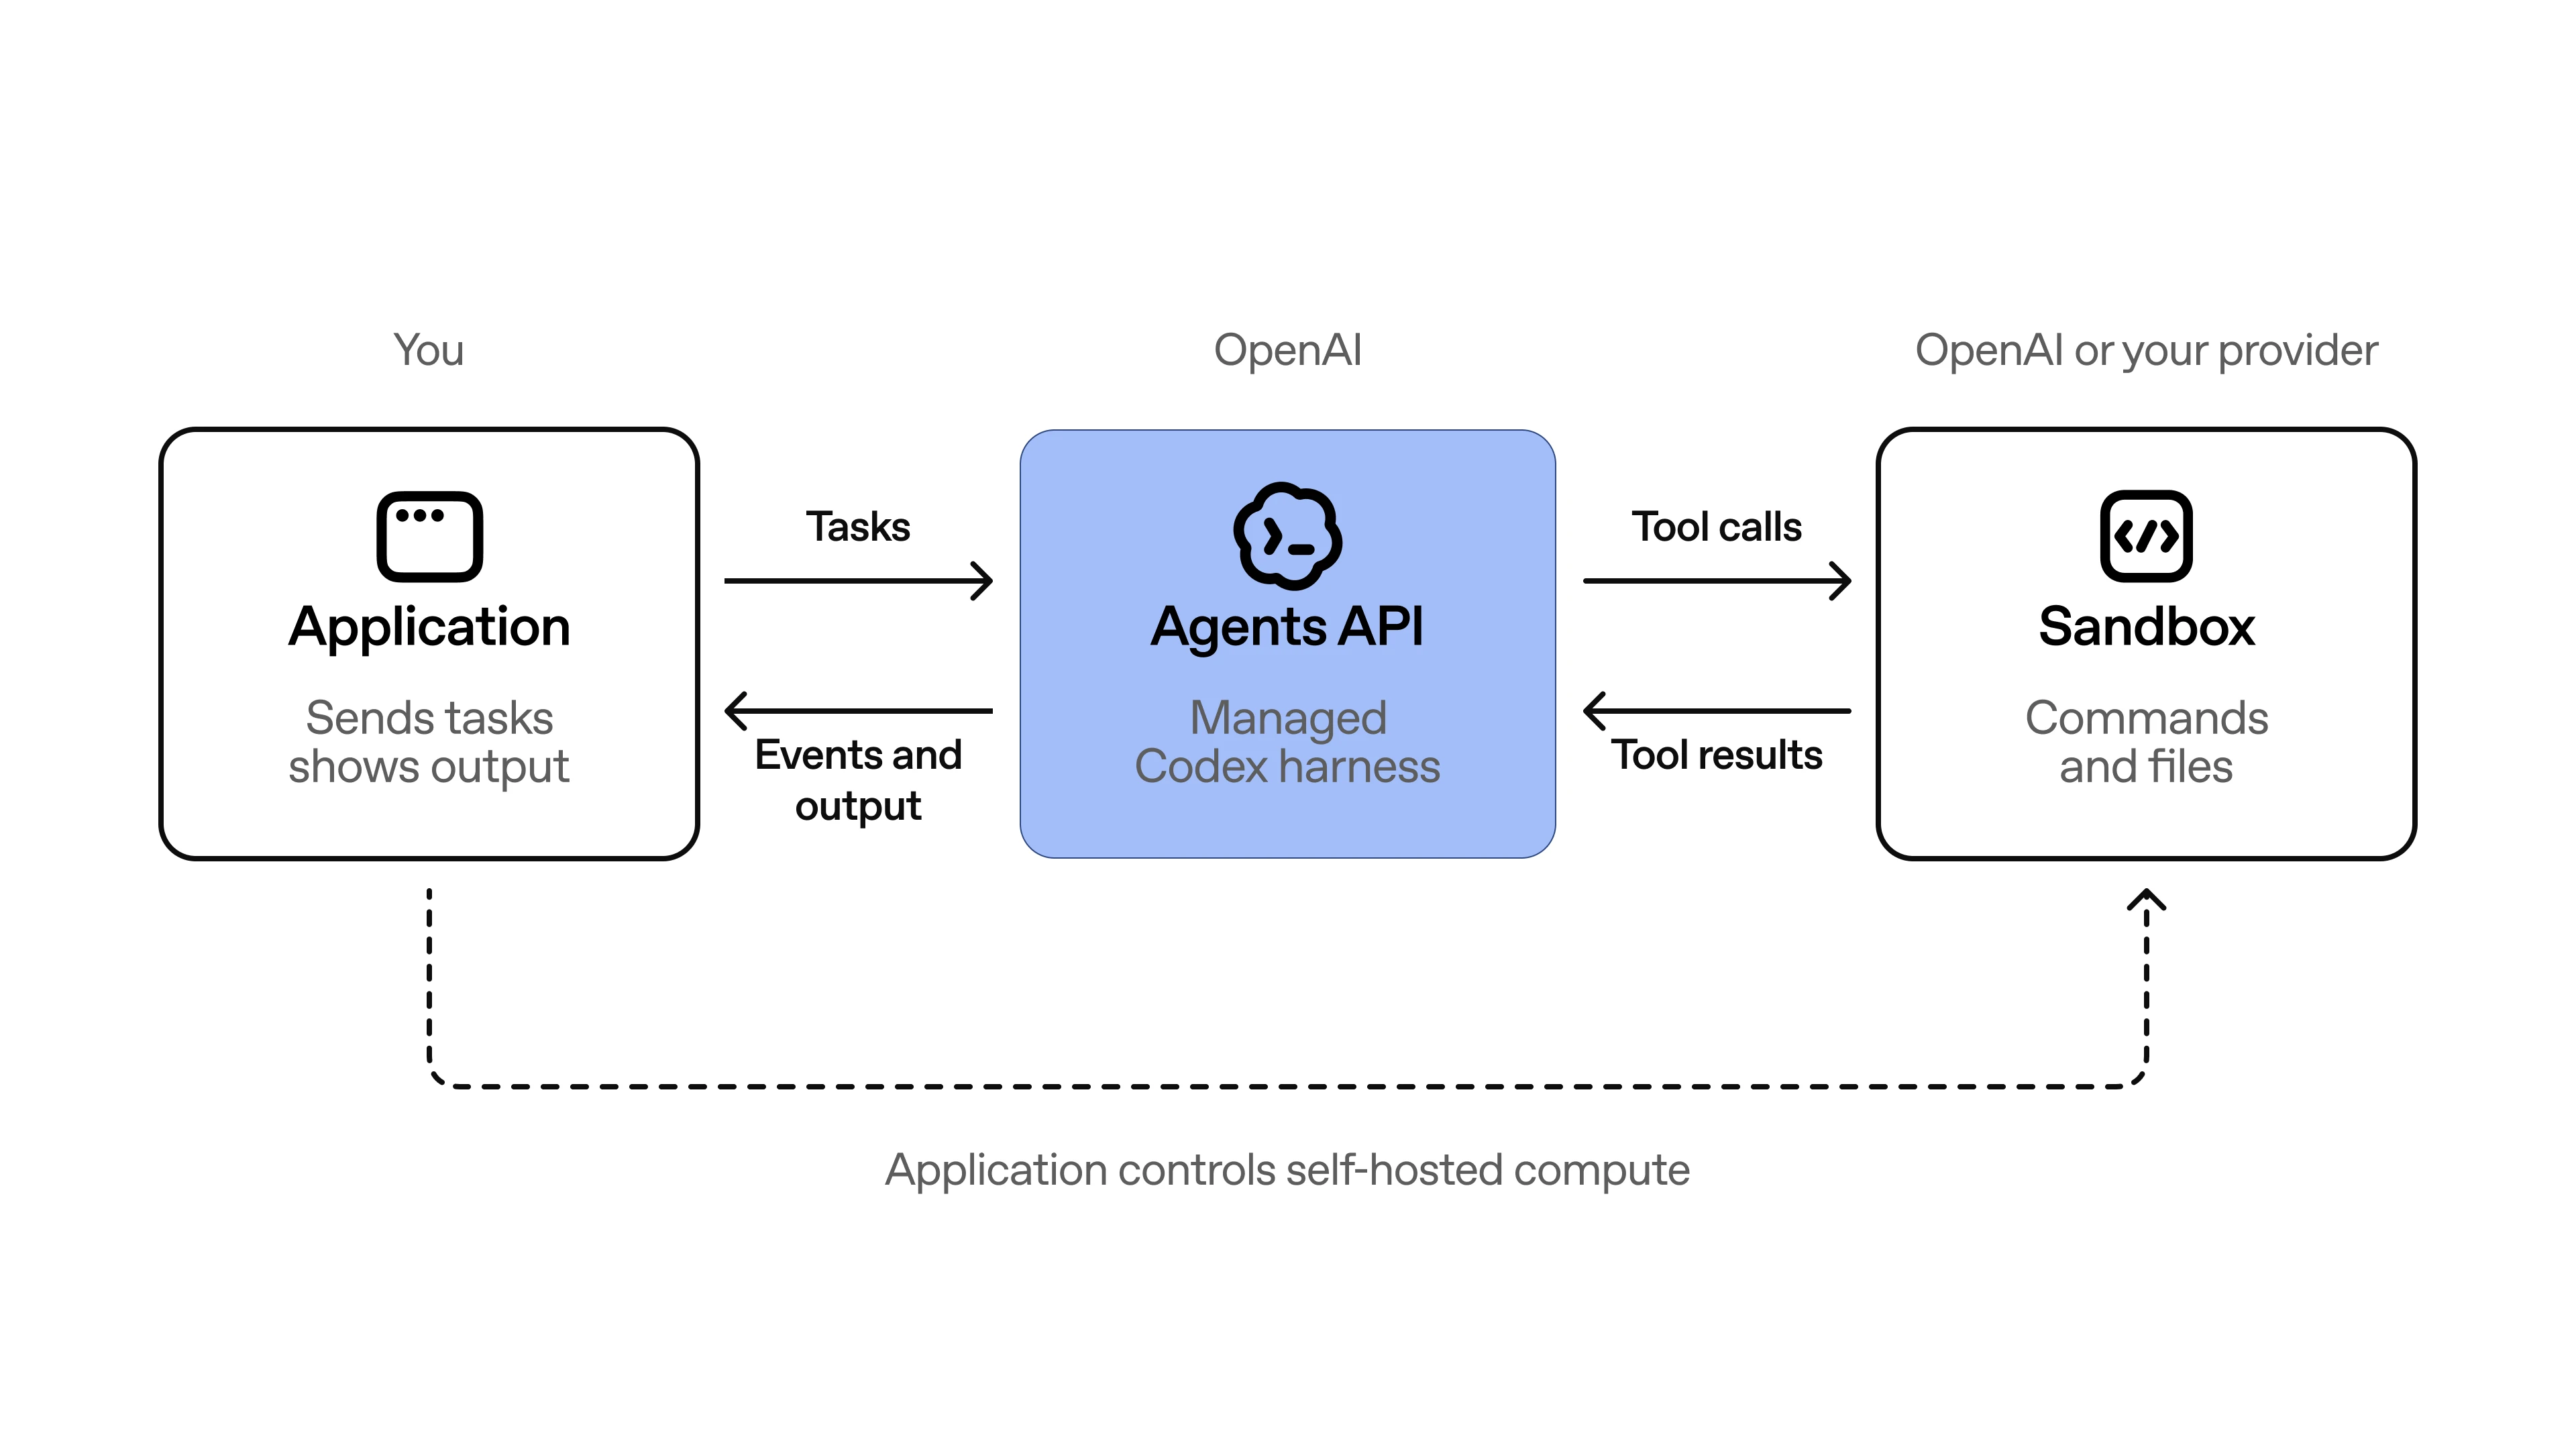
API de agentes é a camada de contrato entre o seu sistema e um runtime de IA que decide, executa ferramentas e devolve resultado. Em vez de receber uma string e retornar outra string, ela recebe um objetivo, consulta as ferramentas disponíveis e conduz uma execução em múltiplos passos.
Definição operacional: quando você chama uma API de agente, está iniciando uma sessão de trabalho autônomo. O retorno final é apenas a ponta visível de um processo que incluiu planejamento, chamadas de função e observação de resultados.
Agente de IA ou chatbot: quem escolhe o próximo passo
Um chatbot aguarda a próxima mensagem. Um agente recebe um objetivo e escolhe as próximas ações. A diferença não é o modelo, é o controle de fluxo. No chatbot, o fluxo é definido pelo usuário ou por regras. No agente, o runtime decide quando invocar uma ferramenta, com qual parâmetro e quantas vezes iterar.
Isso aparece na API como function calling. O agente não apenas responde; ele solicita a execução de uma função e usa o resultado para continuar. A API expõe essa capacidade como um contrato declarativo.
O ciclo perceber, planejar, agir e observar dentro de uma única requisição
Uma chamada de API de agente encapsula um ciclo. Primeiro, o agente percebe o estado atual: a mensagem, o histórico e o contexto da sessão. Depois, planeja qual ferramenta chamar ou qual resposta dar. Em seguida, age executando a chamada. Por fim, observa o retorno e decide se conclui ou itera.
Na prática, você não envia uma mensagem e recebe uma frase. Você envia uma mensagem e recebe um rastro de execução com os passos. Esse rastro é essencial para depurar e auditar. Sem ele, qualquer erro vira caixa-preta.
Por que a API de IA deixou de ser só um endpoint de completude de texto
A primeira geração de APIs de linguagem apenas completava texto. O servidor respondia uma continuação. O estado não existia entre chamadas. O modelo não executava nada. Ferramentas eram impossíveis sem código externo.
A chegada do function calling mudou o contrato. O modelo passou a receber descrições de ferramentas em JSON Schema e a decidir quando invocá-las. Isso criou a necessidade de um runtime que gerencia o loop, a memória e as permissões. A API de agente nasceu dessa mudança.
- Ela mantém identidade do agente, prompt versionado e habilidades configuradas.
- Ela gerencia sessão, memória de trabalho e histórico de execução.
- Ela aplica guardrails e políticas de acesso antes de cada ação.
- Ela devolve o resultado final junto com o caminho percorrido.
Os endpoints essenciais que toda API de agentes precisa expor
Independentemente do fornecedor, uma API de agentes madura expõe pelo menos quatro grupos de endpoints: criação e configuração, execução de sessão, gestão de ferramentas e observação. Sem esses contratos, você fica preso a SDKs proprietários.
Criar agente, versionar prompt e publicar skills
O endpoint de criação registra o agente e devolve um identificador. É aqui que você define o prompt versionado: cada mudança de instrução gera uma nova versão, com histórico e possibilidade de rollback. O prompt deixa de ser um texto solto no código e vira um artefato gerenciável.
Junto com o prompt, o agente recebe ferramentas e skills. Uma skill é uma capacidade nomeada que pode ser ativada ou desativada por agente. A publicação de uma skill atualiza o catálogo sem derrubar a produção.
Enviar mensagem, receber por streaming SSE e ler o rastro das ações
O endpoint de execução aceita uma mensagem, um conversation_id e parâmetros de configuração. A resposta pode ser enviada por streaming SSE, entregando texto incremental e eventos de ferramentas em tempo real. Isso mantém a latência percebida baixa em canais como WhatsApp.
Ao final, a API devolve o rastro completo: qual ferramenta foi chamada, com quais argumentos e qual resultado retornou. Esse rastro é o que permite auditar decisões e reproduzir falhas em testes.
conversation_id e memória de sessão: por que o agente não esquece o contexto
O conversation_id é a chave que liga todas as mensagens de uma mesma interação. Sem ele, cada chamada é independente e o agente perde o fio. Com ele, o runtime recupera o histórico, as variáveis de sessão e o estado das ferramentas já executadas.
Essa memória de sessão é o que permite um atendimento de primeiro nível que não repete perguntas já respondidas. E é também o que precisa de políticas de expiração e privacidade, pois guarda dados do usuário final.
Autenticação e permissões na prática: Bearer token, OAuth2 e API key
A autenticação define quem pode criar agente, quem pode enviar mensagem e quem pode listar execuções. As três opções mais comuns são Bearer token, OAuth2 e API key. Cada uma resolve um cenário.
API key é a mais simples: ideal para scripts internos e testes. Bearer token serve para aplicações servidor-a-servidor com escopo definido. OAuth2 é obrigatório quando o agente age em nome de um usuário humano, por exemplo, acessando CRM ou e-mail do cliente.
Na prática, eu prefiro Bearer token para serviços internos e OAuth2 para qualquer ação em nome do usuário. API key fica para scripts de teste, nunca para produção.
Guardrails e RBAC configurados por endpoint
Não basta autenticar. É preciso limitar o que cada credencial pode fazer. Guardrails são políticas de conteúdo e de ação: bloqueiam ferramentas perigosas, impedem envio de dados sensíveis ou limitam o número de passos. RBAC atribui papéis por endpoint: quem pode publicar prompt, quem pode criar subagente, quem pode apenas executar.
Um erro frequente é dar a mesma chave de API para todos os serviços. Se um serviço for comprometido, o agente inteiro fica exposto. A separação por endpoint e por papel reduz o impacto de uma falha.
Como o agente escolhe uma ferramenta: function calling com JSON Schema
A declaração de ferramentas é feita em JSON Schema. Você descreve o nome, os parâmetros, os tipos e a finalidade. O modelo usa essa descrição para escolher a ferramenta certa no momento certo.
O que vai na declaração de uma ferramenta e por que isso muda o resultado
Uma boa declaração tem três partes: nome claro e único, descrição objetiva da função e esquema de parâmetros com tipos e restrições. Exemplo: uma ferramenta de busca de pedidos precisa do número do pedido como string obrigatória e do CPF como validação alternativa.
Quando a descrição é ambígua, o modelo escolhe errado. Ele não adivinha a intenção; ele lê o contrato. Um nome como buscar_dados é inútil. Um nome como buscar_pedido_por_numero resolve. Já vi muita descrição de ferramenta que mais atrapalha do que ajuda; nome genérico é um convite ao erro de seleção.
Descrição boa reduz erro de seleção, mas infla o prompt de sistema a cada turno
Ferramentas bem descritas custam tokens. Cada descrição entra no contexto de cada turno. Se você tem vinte ferramentas com descrições longas, o prompt de sistema cresce e encarece a chamada. O equilíbrio é documentar o essencial, usar exemplos enxutos e revisar periodicamente.
Uma prática eficiente é agrupar ferramentas por domínio e expor apenas as relevantes para cada agente. Assim, o modelo não recebe um catálogo gigante e o custo por turno fica controlado.
API proprietária, framework de código aberto ou plataforma gerenciada: como comparar as três rotas
Existem três rotas principais para colocar um agente em produção. A escolha depende do grau de controle, do tamanho da equipe e das restrições de infraestrutura.
SDKs de provedor de modelo: OpenAI Agents SDK e Gemini API
Os SDKs oferecem o loop de execução e o function calling com pouca configuração. São ideais para protótipos e agentes simples, mas amarram o código ao provedor. Migrar depois exige reescrever a camada de orquestração.
Frameworks com servidor próprio: LangGraph, CrewAI e n8n
Frameworks como LangGraph e CrewAI permitem orquestração em grafo, controle fino do fluxo e execução auto-hospedada. O n8n oferece uma abordagem visual com API REST para integrações. Eles dão liberdade, mas exigem mais operação e instrumentação própria.
Ambiente gerenciado: uma chamada sobe o sandbox e roda o loop completo
O ambiente gerenciado entrega o runtime pronto. Uma única chamada provisiona um ambiente isolado, executa o ciclo e devolve o resultado junto com o identificador do sandbox. Você não gerencia infraestrutura, mas abre mão de controle sobre o ambiente e sobre a retenção de dados.
Plataformas low-code com API REST, de Taskade a Blip e Typebot
Plataformas low-code como Taskade, Blip e Typebot expõem APIs REST para criar e executar agentes sem código. Elas aceleram a entrega, porém limitam a customização profunda do loop e das políticas de segurança.
| Rota | Controle | Setup | Observabilidade | Melhor para |
|---|---|---|---|---|
| SDK de provedor | Alto | Rápido | Parcial | Prova de conceito |
| Framework de código aberto | Total | Médio | Customizável | Sistema com regras próprias |
| Ambiente gerenciado | Baixo | Mínimo | Nativa | Escala com pouca equipe |
MCP e A2A: os protocolos abertos que estão padronizando a integração
Dois protocolos abertos estão mudando a forma como ferramentas e agentes conversam: Model Context Protocol (MCP) e Agent2Agent (A2A).
MCP substitui a API REST da minha ferramenta?
O MCP padroniza a conexão entre um agente e fontes de dados ou ferramentas. Em vez de escrever uma integração sob medida para cada sistema, você expõe um servidor MCP. O agente descobre as capacidades e as chama como se fossem nativas.
Ele não substitui a API REST existente da sua ferramenta. Ele encapsula essa API em um contrato que o agente entende. A vantagem é reduzir o código de integração e facilitar a troca de provedores de modelo.
A2A e a delegação de subtarefas entre agentes de fornecedores diferentes
O A2A resolve a comunicação entre agentes. Se um agente de atendimento precisa delegar uma tarefa de análise para um agente especializado, o A2A define como essa delegação acontece, com autenticação e formato de resultado.
Isso permite montar orquestrações com agentes de fornecedores diferentes, sem amarrar todo o fluxo a um único runtime. É o começo de uma arquitetura orientada a serviços para IA.
Custo real: por que a conta do agente fecha em tokens e não em chamadas
Você não paga por mensagem. Paga por token de entrada e saída, incluindo as descrições de ferramentas e os resultados intermediários. Um agente que usa cinco ferramentas em cadeia consome de três a dez vezes mais tokens do que um chatbot de uma pergunta.
Por isso, a otimização não está em reduzir chamadas, e sim em reduzir tokens por chamada. Menos ferramentas, descrições enxutas e limites de passos controlam o custo melhor do que cortar integrações.
Eu costumo revisar o consumo de tokens por sessão antes de reclamar do preço do fornecedor. Muitas vezes a otimização está nas descrições das ferramentas, não no modelo.
RPM ou TPM: qual limite trava primeiro quando a operação escala
Existem dois limites relevantes: requisições por minuto (RPM) e tokens por minuto (TPM). Em cargas com muitas chamadas curtas, o RPM estoura primeiro. Em cargas com loops longos e respostas extensas, o TPM é o gargalo.
Monitore os dois. Um erro 429 de limite de RPM é diferente de um estouro de TPM. O primeiro pede fila e retry. O segundo pede redução de contexto ou quebra da tarefa em passos menores.
Dúvidas frequentes de quem está montando o primeiro agente
Preciso de framework para usar uma API de agentes ou dá para chamar direto?
Dá para chamar direto com HTTP e JSON. O framework ajuda na orquestração, no tratamento de erros e na instrumentação, mas não é obrigatório. Para um agente simples, uma chamada REST com controle de conversation_id resolve.
Como limitar o número de passos e evitar loop infinito?
Defina um limite de passos por execução na configuração do agente. Cada chamada de ferramenta conta como um passo. Quando o limite é atingido, a API devolve um erro ou força a resposta final. Complemente com timeout por ferramenta para não travar em integrações lentas.
Como testar o agente antes de colocar no atendimento?
Monte um conjunto de casos dourados com entradas reais e saídas esperadas. Rode o agente com tracing ativo e compare o rastro com o esperado. Verifique se as ferramentas certas foram chamadas, se os parâmetros estão corretos e se o conversation_id permanece estável entre turnos.
Eu admito que demorei a levar o versionamento de prompt a sério. Achava que bastava editar o texto e publicar. Até o dia em que uma mudança sutil quebrou um agente de cobrança e ninguém sabia por quê. O trace mostrou que o modelo começou a escolher a ferramenta errada para renegociação. Sem rollback, voltar ao estado anterior custou uma madrugada inteira. Ali entendi que prompt versionado não é burocracia. É o mesmo controle de versão que a gente aplica ao código. E o mesmo vale para o resto: limites de passos, timeout por ferramenta, idempotência. Essas configurações não são extras. São o que separa um agente que sobrevive à primeira semana em produção de um que vira caso de post-mortem. Se você está começando agora, não pule essa parte.
Sandbox remoto: o que muda na arquitetura quando o ambiente é do fornecedor
Um sandbox remoto executa o loop do agente em um ambiente isolado gerenciado pelo provedor. Isso elimina a necessidade de manter servidores próprios, mas transfere a responsabilidade pela segurança e pela retenção de dados.
Quando o dado é sensível, eu evito ao máximo atravessar a fronteira do provedor. Prefiro arquiteturas híbridas, com o sandbox apenas orquestrando.
Privacidade dos dados que passam por um runtime de terceiros
Antes de enviar dados de clientes para um sandbox externo, você precisa mapear o fluxo. O prompt, as mensagens, os resultados das ferramentas e o rastro de execução podem trafegar por servidores fora do Brasil. A LGPD exige base legal e transparência, mesmo quando o processamento é terceirizado.
Uma saída comum é manter os dados sensíveis nas suas APIs internas e usar o sandbox apenas para orquestração. O agente chama a ferramenta, mas o dado crítico não atravessa a fronteira. Essa arquitetura reduz exposição, embora aumente a latência.
Sinais de que auto-hospedar o agente vale o esforço
Auto-hospedar significa rodar o runtime do agente na sua infraestrutura, seja com um framework de código aberto ou com um servidor próprio. Vale quando os dados são altamente regulados, quando a latência de rede para o provedor é alta ou quando o volume de tokens torna o custo do sandbox proibitivo.
O preço da auto-hospedagem é operação: atualizar runtime, monitorar loops, provisionar recursos e garantir alta disponibilidade. Se a equipe não tem fôlego para isso, um ambiente gerenciado pode ser mais seguro.
| Critério | Sandbox remoto | Auto-hospedado |
|---|---|---|
| Controle de dados | Menor | Total |
| Setup inicial | Mínimo | Alto |
| Responsabilidade operacional | Do provedor | Da sua equipe |
| Latência de rede | Depende da região | Controlada |
Prompt versionado: tratar a instrução como artefato de software
O prompt não é um texto descartável. É o comportamento do agente. Versionar significa guardar cada mudança, quem fez e quando. Isso permite auditoria e recuperação rápida quando uma alteração degrada a qualidade.
Rollback de prompt sem derrubar a produção
Com versionamento ativo, voltar para uma versão anterior é uma operação de API, não um deploy de emergência. Basta apontar o agente para a versão estável. Esse processo leva segundos e reduz o risco de indisponibilidade.
Teste A/B entre duas versões de prompt com tráfego dividido
Algumas APIs permitem dividir o tráfego entre duas versões de prompt e comparar o desempenho. Isso é essencial para validar uma melhoria sem afetar todos os usuários. As métricas de comparação devem incluir taxa de conclusão, acerto de ferramenta e custo por sessão.
O gargalo está fora do modelo: latência de ferramentas externas
O modelo pode responder em centenas de milissegundos. Mas se a ferramenta que ele chama demora três segundos para retornar, a experiência inteira degrada. Em canais de mensagem, latência acima de dois segundos por ferramenta externa destrói a conversa.
O que dois segundos de espera fazem com a experiência no WhatsApp
No WhatsApp, o usuário espera resposta imediata. Um atraso de dois segundos já gera ansiedade. Se o agente chama três ferramentas em sequência, a espera total pode passar de cinco segundos. O usuário desiste ou repete a mensagem, gerando mais chamadas e mais custo.
A mitigação é paralelizar chamadas independentes, cachear respostas e reduzir o número de passos. Cada segundo economizado em ferramenta é um segundo a menos de conversa perdida.
Idempotência e fallback para chamadas que falham no meio do loop
Quando uma ferramenta falha, o agente precisa de uma política de retry ou fallback. Retry sem idempotência pode duplicar uma ação de escrita, como lançar cobrança duas vezes. Idempotência garante que repetir a mesma chamada não gere efeito colateral duplicado.
Antes de liberar uma ferramenta de escrita, exija uma chave de idempotência. Sem ela, um timeout de rede pode virar um problema financeiro.
Tracing de agente: enxergar o loop antes que ele estoure a fatura
Sem tracing, o agente é uma caixa-preta. Você vê a pergunta e a resposta, mas não as ferramentas chamadas, os argumentos usados nem os loops repetidos. O tracing expõe tudo. Sem tracing, eu me sinto dirigindo sem painel. É impossível saber onde o agente travou sem o rastro completo.
Que eventos registrar em cada turno
Registre o prompt da versão ativa, a mensagem do usuário, a decisão de ferramenta, os parâmetros, o resultado retornado, o tempo de cada etapa e o número de tokens consumidos. Esses campos são suficientes para diagnosticar a maioria dos problemas.
Como reconhecer um loop de repetição pelo trace
Um loop aparece no trace como uma sequência de chamadas idênticas à mesma ferramenta, com os mesmos parâmetros, sem progresso. O agente tenta, falha e tenta de novo. Isso consome tokens rapidamente. Ao detectar, interrompa a sessão e ajuste a descrição da ferramenta ou adicione um critério de parada.
APIs de agentes no mercado brasileiro: WhatsApp Business Platform, ERP e CRM
No Brasil, a adoção prática passa por três pontos de integração: canais de mensagem, sistemas de gestão e bases de dados internas. O WhatsApp Business Platform é o canal dominante, enquanto ERPs e CRMs concentram as regras de negócio.
Atendimento de primeiro nível com escalonamento para humano
O agente responde dúvidas frequentes, consulta pedidos e abre chamados. Quando não resolve, transfere para um atendente humano com o contexto completo. O conversation_id preserva o histórico, e o rastro de execução ajuda o humano a entender o que já foi tentado.
Qualificação de leads e cobrança dentro do CRM
A API de agente consulta o CRM para qualificar um lead: verifica cargo, empresa, histórico de interações e intenção. Depois, aciona uma sequência de cobrança com regras de negócio. A autorização por OAuth2 garante que o agente aja em nome do vendedor, não com uma chave mestra.
Orquestração multiagente: dividir a tarefa para quê?
Multiagente é útil quando cada subtarefa exige um contexto muito específico. Um agente de atendimento pode delegar a um agente de análise de documentos, a um agente de cobrança e a um agente de suporte técnico. Cada um tem seu prompt e suas ferramentas.
Custo de coordenação e o efeito no consumo de tokens
A divisão não é gratuita. Cada mensagem entre agentes consome tokens, e o orquestrador precisa resumir o contexto para cada delegação. Em tarefas simples, o custo de coordenação supera o benefício. Em tarefas complexas, a especialização reduz erros e retrabalho.
Quando um único agente resolve melhor
Se a tarefa cabe em um único domínio, um agente bem configurado é mais barato e mais previsível. A complexidade de múltiplos agentes só se justifica quando há fronteiras claras de responsabilidade e bases de conhecimento distintas.
Como avaliar e testar um agente antes do go-live
Testes manuais não escalam. Você precisa de um conjunto automatizado de casos dourados e métricas de qualidade contínua.
Métricas que importam além da taxa de acerto
Taxa de conclusão, tempo médio de resolução, custo por sessão, número de passos por execução, taxa de escalonamento humano e taxa de erro de ferramenta. Essas métricas mostram saúde operacional, não apenas qualidade de resposta.
Regressão de prompt e conjunto de casos dourados
A cada mudança de prompt, rode o conjunto dourado. Se qualquer caso regredir, você vê exatamente qual entrada quebrou. Esse processo evita que uma melhoria pontual destrua um fluxo que já funcionava.
Dependência de fornecedor: o que realmente custa migrar depois
A migração custa caro quando a lógica de orquestração e o estado da sessão estão acoplados ao SDK do provedor. Se o código chama diretamente a API proprietária, trocar de fornecedor exige reescrever tudo.
Camadas de abstração que salvam a migração
Isole o acesso ao runtime atrás de uma interface própria. Defina contratos internos para criar agente, enviar mensagem e listar execuções. Assim, trocar de provedor vira uma implementação nova, não um novo sistema.
Low-code resolve tudo? Onde o contrato de API continua obrigatório
Low-code acelera a entrega, mas não elimina a necessidade de contrato. Quando o agente precisa se integrar a sistemas internos, aplicar políticas de acesso granulares ou executar ações com efeito colateral, a API REST por trás do low-code é o que garante segurança e auditoria.
Sem esse contrato, o low-code vira um bloco de notas sofisticado: bonito, mas incapaz de sustentar regras de negócio reais.
Erros que quebram agentes em produção
Os erros mais caros não são de código. São de configuração e de contrato.
Ferramentas mal descritas e o efeito cascata na escolha errada
Uma descrição ambígua faz o modelo escolher a ferramenta errada. O sintoma é simples: o agente tenta consultar pedido com o nome do cliente ou busca produto com o CPF. O erro propaga e o usuário perde a confiança.
Ações com efeito colateral sem idempotência
Enviar e-mail, lançar cobrança, criar pedido. Todas precisam de idempotência. O sintoma clássico é duplicação: o cliente recebe duas cobranças ou dois e-mails. E a correção é manual, lenta e constrangedora.
Guardrails genéricos demais para regras de negócio específicas
Guardrail genérico bloqueia ofensa, mas não bloqueia desconto acima do permitido. O sintoma é um agente educado que aprova condições fora da política. As regras de negócio precisam viver na camada de ferramentas, não no prompt solto.
- Sintoma de descrição ruim: ferramenta errada escolhida repetidamente.
- Sintoma de falta de idempotência: ação duplicada após retry.
- Sintoma de guardrail fraco: violação de política sem bloqueio.
- Sintoma de tracing ausente: impossibilidade de reproduzir erro em produção.
O que observar nos próximos ciclos da categoria
Padronização de protocolos e o fim das integrações sob medida
A tendência é clara: o MCP padroniza ferramentas, o A2A padroniza comunicação entre agentes e os provedores de modelo padronizam o loop de execução. O resultado é menos código de integração e mais foco em regras de negócio.
Isso não significa que tudo vai virar plug-and-play. Mas reduz a carga de manutenção e permite trocar peças da arquitetura sem reescrever o sistema. Quem desenhar contratos internos agora terá vantagem nos próximos ciclos.
O plano de ação para não começar pelo caminho errado
Na Prática · O Que Fica
- 01A Escolha Certa: Se você precisa de controle total e dados sensíveis em casa, escolha auto-hospedar com um framework de código aberto. Se a equipe é pequena e o tempo é curto, um ambiente gerenciado com sandbox remoto entrega mais rápido.
- 02Ponto de Atenção: Muita gente acha que agente é sinônimo de chatbot. O custo e a complexidade aparecem quando as ferramentas começam a falhar ou a consumir tokens em loop.
- 03Na Prática: Hoje, liste as suas três primeiras ferramentas e escreva a descrição com nome objetivo e JSON Schema enxuto. Depois, defina um limite de passos igual a três para o protótipo.
Construir com API de agentes exige mudar a mentalidade de integração. Você não está consumindo um endpoint de texto. Está orquestrando um runtime que decide e age. Quem entende isso evita o erro mais caro: tratar agente como chat.
Comece pequeno. Escolha um caso real, declare duas ou três ferramentas bem descritas, ative tracing e versionamento de prompt. Coloque em um ambiente de teste com conversation_id e observe o rastro. Aprenda com os erros do loop antes de abrir para o público.
O caminho não é sobre acertar de primeira. É sobre ter contrato para voltar atrás quando errar.
O que pouca gente sabe: Antes de produção, um agente precisa de oito itens: limite de passos por execução, timeout por ferramenta, chave de idempotência em ações de escrita, versionamento de prompt ativo, guardrails por canal, tracing ligado, teto de tokens por sessão e plano de escalonamento humano. Cada falta tem um sintoma: loop sem limite estoura token, timeout ausente trava conversa, idempotência sem chave duplica cobrança, prompt sem versão impede rollback, guardrail genérico deixa passar regra de negócio, tracing desligado vira caixa-preta, sem teto de tokens a sessão vira prejuízo financeiro e sem escalonamento humano o cliente fica preso com a máquina.
