
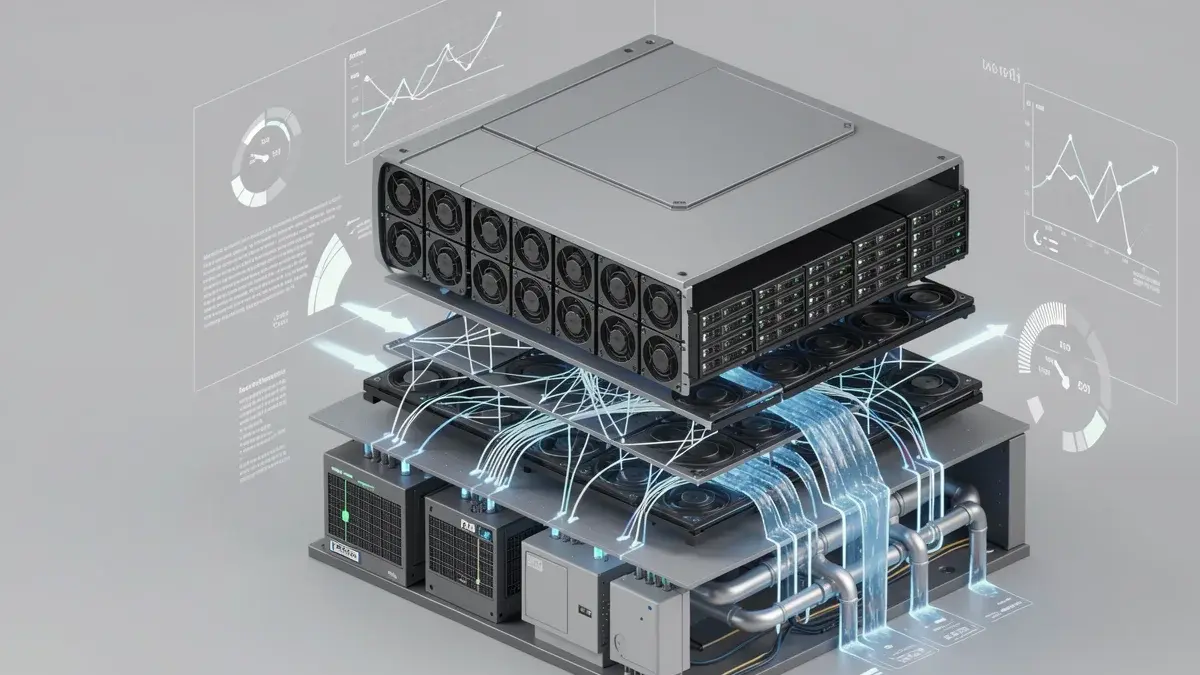
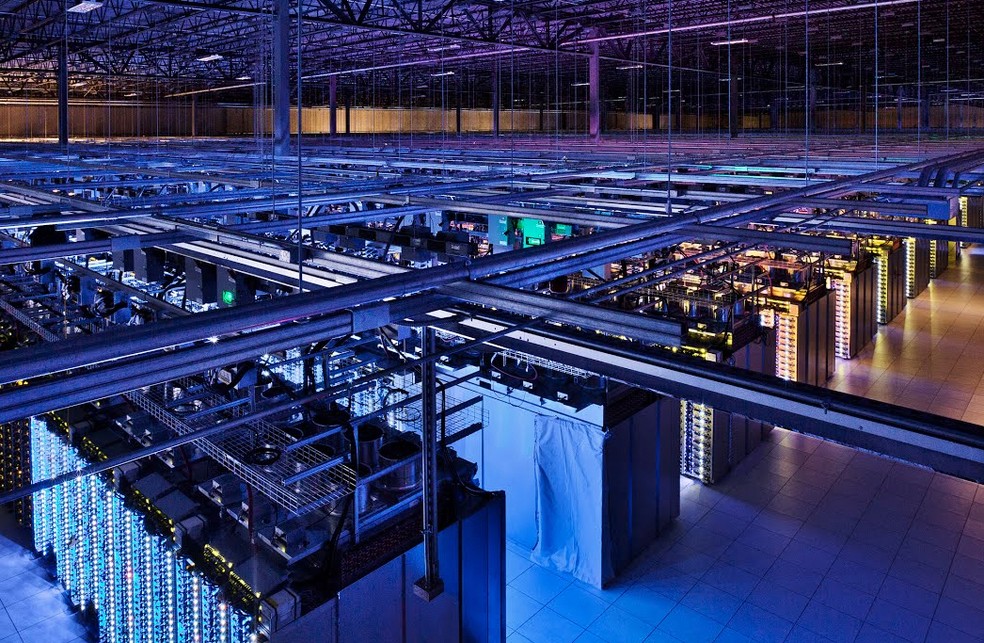
Quando você faz uma pergunta a um assistente de IA, a resposta não vem de uma nuvem etérea. Ela emerge de um complexo industrial frio e barulhento: corredores de servidores, quilômetros de fibra e transformadores que sustentam o processamento.
Eu costumo começar por essa camada física, porque é onde o orçamento some sem aviso.
O problema? O noticiário fala de modelos, benchmarks e parcerias bilionárias, mas raramente desce ao nível do rack. E é lá em baixo que o custo, a velocidade e os limites da IA são definidos.
- Infraestrutura de IA é o conjunto de hardware e software que sustenta o ciclo de vida dos modelos, desde o treinamento até a inferência.
- Os principais componentes incluem aceleradores como GPU e TPU, servidores com interconexões de alta velocidade, redes de baixa latência, armazenamento paralelo e sistemas de energia e refrigeração dimensionados para alta densidade.
- A eficiência de um data center é medida por métricas como PUE, latência e utilização do acelerador, e esses números determinam o custo final por token processado.
- Treinar um modelo exige milhares de aceleradores trabalhando em conjunto, enquanto a inferência prioriza baixa latência e proximidade do usuário.
- No Brasil, fatores como latência internacional, custo de energia e exigências da LGPD influenciam a escolha entre nuvem, colocation e infraestrutura própria.
- Como as sete camadas da pilha de IA se conectam, do silício ao software de orquestração.
- Por que a escolha entre treinar e rodar um modelo muda completamente a arquitetura necessária.
- Os gargalos escondidos que fazem um cluster caro ficar ocioso e como corrigi-los.
- O que a latência entre Brasil e EUA tem a ver com a sua fatura de nuvem?
O que sustenta a conversa com a máquina
Um modelo de linguagem não existe sozinho. Ele é um software, mas depende de um edifício inteiro para pensar. Cada palavra que ele gera aciona uma corrente de eventos físicos: transistores chaveiam, dados atravessam placas, bombas empurram líquido frio e medidores registram consumo.
Essa corrente tem mais pontos de falha do que se imagina. E cada ponto de falha tem um preço. Um cabo mal dimensionado pode dobrar o tempo de treinamento. Uma refrigeração insuficiente pode derrubar um rack inteiro no meio da noite.
Antes de qualquer decisão de arquitetura, meça a latência real entre onde o dado nasce e onde ele será processado. Esse número costuma ser o primeiro critério de corte.
O que é infraestrutura de IA — o mapa da pilha, do silício ao transformador
Infraestrutura de IA é a fundação sobre a qual modelos de machine learning são treinados, ajustados e colocados em produção. Ela não é apenas hardware: inclui também a camada de software que orquestra cada recurso. Sem essa base, nenhum parâmetro é atualizado, nenhum token é gerado.
As sete camadas da pilha explicadas em uma frase cada
- Silício: aceleradores como GPU, TPU e ASIC executam as operações matemáticas em paralelo.
- Servidor: agrupa vários aceleradores e os conecta com interconexões de alta velocidade.
- Rede: liga centenas ou milhares de servidores para que trabalhem como um único sistema.
- Armazenamento: alimenta os aceleradores com dados e salva checkpoints durante o treinamento.
- Data center: abriga os racks e resolve o desafio de dissipar o calor gerado.
- Energia: fornece potência elétrica estável, com redundância para evitar paradas.
- Software: agendadores e ferramentas de orquestração mantêm o conjunto ocupado e saudável.
Por que a base física define custo, velocidade e limites do modelo
Um modelo de IA não é uma abstração. Ele depende de operações físicas: elétrons se movem, calor é dissipado, bits viajam por cabos. A velocidade desses fenômenos impõe um teto ao que o software pode alcançar.
Se a rede entre dois servidores tem latência de 10 microssegundos, nenhum algoritmo mágico fará a comunicação ser mais rápida. Se um acelerador consome 700 watts, a sala precisa remover exatamente essa energia térmica.
Quando a IA deixou de ser experimento e virou carga industrial
Durante décadas, treinar um modelo era algo que cabia em uma estação de trabalho. O cenário mudou quando modelos generativos passaram a exigir milhares de aceleradores por semanas. A infraestrutura deixou de ser coadjuvante e virou um dos maiores custos do projeto.
Esse deslocamento empurrou data centers para novos patamares de densidade elétrica e forçou a indústria a repensar refrigeração, rede e até a localização geográfica das instalações.
Camada 1: o silício onde a IA de fato acontece
GPU, TPU, NPU e ASIC: o que muda no projeto de cada acelerador
O processador tradicional, a CPU, é bom em tarefas sequenciais e controle lógico. Para IA, precisamos de chips que façam muitas operações matemáticas ao mesmo tempo. Cada tipo de acelerador resolve esse problema de um jeito.
| Acelerador | Característica principal | Uso típico |
|---|---|---|
| GPU | Alta paralelização; ecossistema maduro | Treinamento e inferência |
| TPU | Otimizada para multiplicações de matrizes | Treinamento em nuvem |
| NPU | Baixo consumo; focada em inferência | Dispositivos de borda |
| ASIC | Projetada para uma tarefa específica | Inferência em escala |
HBM e largura de banda: o gargalo que não aparece no marketing
De nada adianta um chip muito rápido se ele não recebe dados na mesma velocidade. A memória HBM (High Bandwidth Memory) empilha camadas para entregar centenas de gigabytes por segundo. Sem isso, os núcleos do acelerador ficariam ociosos esperando dados.
Essa é uma das razões por que aceleradores para servidores custam caro: eles precisam dessa memória de alta velocidade e da interconexão que a acompanha.
TDP e litografia: por que cada watt virou decisão de arquitetura
TDP (Thermal Design Power) indica quanto calor o chip dissipa em operação máxima. Um acelerador moderno pode passar de 500 watts. Isso obriga o sistema de refrigeração a evacuar mais calor por centímetro quadrado do que nunca.
A litografia, medida em nanômetros, define o tamanho dos transistores. Processos menores reduzem consumo por operação, mas o ganho total é limitado pela física: cada geração fica mais difícil e mais cara de fabricar.
Camada 2: dentro do servidor de IA
Oito aceleradores na mesma placa: NVLink, PCIe e o custo de mover dados
Um servidor de IA típico abriga quatro a oito aceleradores, cada um com sua própria memória. Para treinar um modelo, eles precisam trocar dados constantemente. Se a comunicação entre eles for lenta, o treinamento inteiro fica lento.
Por isso, placas-mãe específicas usam interconexões dedicadas, como NVLink, que oferecem taxa de transferência muito superior ao PCIe tradicional. A diferença entre usar um barramento lento e um rápido pode ser um treinamento de semanas virar dias.
Fontes redundantes e BMC: o que mantém o nó de pé quando algo falha
Queda de energia é fatal durante um treinamento longo. Fontes redundantes garantem que uma falha em uma fonte não desligue o servidor. E o BMC (Baseboard Management Controller) permite monitorar e controlar o hardware remotamente, mesmo quando o sistema operacional não responde.
Esses componentes não aceleram o modelo, mas evitam que horas de processamento sejam perdidas. Em infraestrutura de produção, a confiabilidade é tão crítica quanto o desempenho.
Camada 3: a rede que decide o desempenho do cluster
InfiniBand, RoCE e Ethernet 400G: qual usar em cada cenário
Em um cluster, a rede é o sistema nervoso. Três tecnologias dominam: InfiniBand, RoCE (RDMA over Converged Ethernet) e Ethernet 400G. Elas diferem em latência, banda e custo de implantação.
| Tecnologia | Latência típica | Largura de banda | Custo relativo |
|---|---|---|---|
| InfiniBand | Extremamente baixa | 400 Gb/s por porta | Alto |
| RoCE | Baixa | 400 Gb/s por porta | Médio |
| Ethernet 400G | Moderada | 400 Gb/s por porta | Menor |
Spine-leaf e fat-tree: topologias que evitam congestionamento
Conectar milhares de servidores exige um desenho de rede que evite gargalos. A topologia spine-leaf conecta cada servidor a um switch de folha, e cada folha a todos os spines. Isso garante que qualquer servidor alcance qualquer outro com o mesmo número de saltos.
Fat-tree é uma generalização para clusters maiores, criando múltiplos níveis. Ambas visam garantir latência leste-oeste baixa e consistente, essencial para treinamento distribuído.
Latência leste-oeste: o gargalo invisível na fatura do treino
Durante o treinamento distribuído, os aceleradores trocam gradientes a cada iteração. Se a rede entre eles tiver latência alta, cada passo leva mais tempo. Em um cluster com milhares de aceleradores, a soma desses atrasos pode representar uma fração significativa do tempo total.
Medir e otimizar a latência entre servidores é tão importante quanto escolher um bom acelerador. Na prática, já encontrei clusters com ótimos aceleradores e rede ruim, e o resultado era pior que um cluster menor com rede bem dimensionada.
Camada 4: armazenamento para aceleradores famintos por dados
NVMe paralelo e object storage: quem guarda o quê
O armazenamento tem dois papéis distintos. O primeiro é alimentar os aceleradores com dados de treinamento tão rápido quanto possível. Para isso, usa-se armazenamento NVMe em paralelo, que lê dados em alta velocidade e com baixa latência.
O segundo papel é guardar datasets, modelos e artefatos de forma durável. Object storage entra aqui: ele escala para petabytes, mas não tem o mesmo desempenho que NVMe local.
Checkpoints: o custo escondido de salvar o treinamento
Durante o treinamento, o modelo salva checkpoints periódicos para permitir retomada em caso de falha. Cada checkpoint grava o estado do modelo em armazenamento não volátil. Se isso for lento, o treinamento pausa até a gravação terminar.
Modelos grandes podem gerar checkpoints de dezenas de gigabytes. Otimizar a velocidade de escrita é uma decisão que afeta diretamente o tempo total do projeto.
Camada 5: data center, densidade de rack e refrigeração
De 5–15 kW a 100 kW por rack: o que muda quando a densidade explode
Um rack tradicional de servidores consome entre 5 e 15 kW. Racks de IA podem passar de 40 kW e chegar a 100 kW ou mais. Esse salto muda tudo: a capacidade elétrica da sala, o sistema de refrigeração e até a estrutura do piso.
Um corredor cheio de racks de 100 kW gera calor equivalente a dezenas de fornos industriais. A gestão térmica deixa de ser um detalhe e vira o principal desafio.
Corredor quente/frio, líquido direto ao chip e imersão: quando cada um faz sentido
Em data centers tradicionais, o ar frio é soprado pelo corredor frio e o ar quente sai pelo corredor quente. Essa abordagem funciona bem até densidades moderadas. Acima de certo limite, o ar simplesmente não remove calor rápido o bastante.
Aí entram soluções mais agressivas. A refrigeração líquida direta ao chip leva líquido frio até o componente, removendo calor na fonte. A imersão mergulha o servidor inteiro em um fluido dielétrico. Ambas permitem densidades muito maiores, mas exigem infraestrutura dedicada e manutenção especializada.
PUE e WUE: medindo a eficiência real de um data center de IA
Por que 1,1 e 1,8 parecem próximos e custam muito diferente
PUE (Power Usage Effectiveness) é a razão entre a energia total consumida pela instalação e a energia consumida apenas pelos equipamentos de TI. PUE de 1,1 significa que 90% da energia vai para computação e apenas 10% é perdida em refrigeração e perdas elétricas. PUE de 1,8 significa que quase metade da energia é desperdiçada.
Em uma instalação com consumo de megawatts, essa diferença representa uma fatura elétrica anual muito maior. Por isso, projetos modernos perseguem PUE entre 1,1 e 1,4, segundo referências da ASHRAE.
WUE (Water Usage Effectiveness) mede o consumo de água, que também cresce com a refrigeração líquida e evaporativa. A sustentabilidade dessa infraestrutura não é apenas uma questão ambiental, mas financeira.
Reformar a sala ou migrar? A conta real
Adaptar uma instalação antiga para refrigerar racks de 100 kW pode exigir trocar todo o sistema de distribuição de água, instalar bombas mais potentes e reforçar o piso. Em muitos casos, migrar para um colocation já preparado para alta densidade sai mais barato e rápido.
A decisão não é técnica apenas: envolve custo de capital, prazo e tolerância a risco. Um erro comum é subestimar a complexidade de reformar sem desligar os racks existentes.
Camada 6: energia, a camada que decide se o projeto existe
Subestação, UPS e gerador: redundância N+1 na prática
Um data center de IA não pode depender de uma única fonte de energia. A redundância N+1 significa ter um componente sobressalente para cada tipo de falha. Subestações transformam a alta tensão da rede em níveis utilizáveis. UPS (no-break) sustenta a carga até que geradores assumam.
Geradores a diesel são acionados em segundos após uma queda. Sem esse esquema, uma simples falha na rede externa poderia interromper um treinamento de semanas.
Demanda contratada e tarifa: a conta que ninguém mostra no orçamento
No Brasil, a conta de energia de uma instalação de processamento tem dois componentes: o consumo e a demanda contratada. A demanda é o valor máximo de potência que a concessionária se compromete a fornecer. Se a instalação ultrapassa esse limite, paga multa pesada.
Dimensionar a demanda contratada corretamente exige prever o pico de consumo dos racks. Errar para cima significa pagar por energia não usada; errar para baixo, pagar multas. Essa é uma decisão estrutural, muitas vezes ignorada em projetos apressados.
Camada 7: orquestração, agendadores e MLOps
Como agendadores de GPU evitam ociosidade caríssima
Com dezenas ou centenas de aceleradores, é impossível gerenciar alocações manualmente. Agendadores como Kubernetes recebem pedidos de recursos e decidem onde cada tarefa roda. O objetivo é maximizar o aproveitamento dos aceleradores, que são recursos caríssimos.
Um acelerador ocioso representa dinheiro parado. O agendador também garante que tarefas de treinamento e inferência convivam sem conflito, priorizando o que tem maior impacto no negócio.
Observabilidade: as métricas que dizem se a pilha está saudável
Coletar métricas de desempenho é essencial. Taxa de uso dos aceleradores, temperatura, latência de rede e vazão de armazenamento são indicadores que mostram onde estão os gargalos. Sem observabilidade, a equipe opera às cegas, reagindo a problemas depois que eles acontecem.
Ferramentas de monitoramento enviam alertas quando algo sai do intervalo esperado. Isso permite correções proativas, como rebalancear tarefas ou substituir um componente defeituoso antes que cause interrupção.
Treinar e rodar exigem infraestruturas diferentes
O perfil de um cluster de treinamento distribuído
Treinar um modelo de linguagem grande é uma maratona. Exige milhares de aceleradores, rede de altíssima velocidade e armazenamento rápido. O cluster opera por semanas em carga máxima, com tolerância a falhas controlada por checkpoints.
A configuração é orientada para throughput: quantos exemplos de treinamento podem ser processados por segundo. Latência individual é menos crítica, mas a comunicação coletiva entre aceleradores é fundamental.
O perfil da inferência em produção
Inferência é servir o modelo treinado a usuários finais. Aqui, a prioridade muda para tokens por segundo e baixa latência. O usuário não quer esperar mais de alguns segundos por uma resposta.
O hardware ainda usa aceleradores, mas geralmente menos poderosos e mais baratos. A escala é de requisições concorrentes, não de operações paralelas massivas. A localização do data center importa: cada milissegundo de latência conta.
Treino na nuvem, inferência perto do usuário: por que o híbrido virou padrão
Treinar um modelo grande exige recursos que raramente ficam disponíveis o tempo todo. A nuvem pública oferece elasticidade: aluga-se o cluster por algumas semanas e depois devolve-se. Para inferência, porém, a proximidade do usuário reduz latência e pode atender exigências de soberania de dados.
Empresas reguladas, especialmente no Brasil, optam por manter a inferência em data centers locais ou em colocation. O padrão emergente é híbrido: treino na nuvem, inferência na borda ou em infraestrutura própria.
Dúvidas rápidas sobre infraestrutura de IA
Meu computador com placa de vídeo já não faz o mesmo papel?
Para testes e experimentos pequenos, uma placa de vídeo de consumo funciona. Ela não tem a memória, a largura de banda nem a confiabilidade das aceleradores de data center, mas é suficiente para aprender e prototipar.
Em produção, no entanto, a história muda. Modelos grandes exigem mais memória do que qualquer placa de consumidor oferece, e treinar em escala requer interconexões e redundâncias que só existem em servidores dedicados.
Dá para rodar IA sem data center próprio?
Sim, e essa é a escolha mais comum. Nuvens públicas oferecem instâncias com aceleradores, pagas por hora. Alternativamente, colocation permite colocar seu próprio hardware em um data center terceirizado, aproveitando a infraestrutura elétrica e de refrigeração sem construir um prédio.
A decisão depende de custo, latência desejada e requisitos de conformidade. Muitas empresas usam nuvem para picos e colocation para cargas estáveis.
A LGPD influencia onde os dados podem ser processados?
A LGPD não proíbe processar dados no exterior, mas exige que o tratamento siga as regras brasileiras, incluindo transferência internacional adequada. Para dados sensíveis, a prática de muitas empresas é manter o processamento em território nacional. Isso afeta a escolha da região de nuvem e a decisão de investir em infraestrutura local.
Consulte sempre um especialista jurídico para avaliar o caso concreto, mas a tendência é que soberania de dados pese cada vez mais na arquitetura.
Quando comecei a dimensionar clusters para clientes, percebi que a maior parte do custo não estava no hardware. Estava na ineficiência: aceleradores ociosos, rede subdimensionada, refrigeração errada. Um rack de 100 kW mal planejado pode custar mais em energia do que em servidores. E o pior é que muitos gestores só descobrem isso quando a fatura chega.
Minha regra prática é simples: antes de comprar qualquer acelerador, calcule a utilização esperada. Se você não consegue manter a utilização acima de 50%, repense a arquitetura. A culpa raramente é do chip.
Por que a refrigeração líquida virou padrão em racks de altíssima densidade
Com densidades de rack acima de 40 kW, o ar não consegue remover calor suficiente. Ventiladores teriam que girar a velocidades impraticáveis, gerando ruído e vibração. A refrigeração líquida resolve isso com um fluido que tem capacidade térmica muito maior que o ar.
Servidores que já saem de fábrica com water block
Fabricantes agora entregam servidores com blocos de água instalados diretamente sobre os aceleradores e módulos de memória. Isso elimina a necessidade de adaptação em campo e reduz o risco de vazamentos. A manutenção, porém, exige equipe treinada e procedimentos rigorosos.
Se o data center atual não foi projetado para alta densidade, o custo de reforma pode superar o de migrar para um colocation. Essa conta envolve energia e refrigeração e é detalhada na seção de eficiência.
Aceleradores proprietários dos hiperescaladores: quando compensam
Grandes provedores de nuvem desenvolveram chips próprios para reduzir custo e dependência. Eles são otimizados para cargas específicas e oferecem preço competitivo por token.
Ganho de custo contra o risco de ficar preso a um fornecedor
Usar um acelerador proprietário pode reduzir a fatura mensal, mas amarra o software a um ecossistema. Migrar depois para outro fornecedor pode exigir reescrever partes do pipeline. A escolha deve considerar o horizonte do projeto: para experimentos de curto prazo, a economia vale; para cargas de longo prazo, a portabilidade pode ser mais importante.
A conta migrou do treinamento para a inferência em escala
O custo de treinar um modelo grande é concentrado no tempo. O custo de inferir é contínuo e proporcional ao número de usuários. À medida que a adoção cresce, a inferência domina o orçamento de infraestrutura.
Custo por token: a métrica que entrou no orçamento corporativo
Métrica simples: divida o custo total da infraestrutura pelo número de tokens processados. Empresas que monitoram custo por token conseguem tomar decisões informadas sobre qual acelerador usar, onde hospedar e quando otimizar o modelo.
Um modelo que gera respostas mais longas sem necessidade aumenta o custo por token. Cortar verbose desnecessário pode ter impacto financeiro maior do que trocar de hardware.
As otimizações que mais derrubam o custo de inferência
- Quantização: reduzir a precisão numérica do modelo sem perder qualidade perceptível.
- Cache de respostas: armazenar respostas comuns para não reprocessar.
- Batching dinâmico: agrupar requisições para melhor utilização do acelerador.
- Escolha da região: colocar a inferência perto do usuário reduz latência e pode reduzir custos indiretos.
Infraestrutura de IA no Brasil: os três gargalos locais
O Brasil tem desafios próprios que afetam qualquer projeto sério de IA. Conhecê-los evita surpresas no orçamento e no cronograma.
100 a 130 ms até os EUA: o número que decide onde inferir
A latência de ida e volta entre o Sudeste e a costa leste dos EUA fica entre 100 e 130 ms. Para uma aplicação interativa que faz múltiplas chamadas, isso pode significar segundos de atraso. Por isso, inferência sensível à latência deve rodar no Brasil ou na América do Sul.
Importação de aceleradores e o impacto no custo de capital
Importar aceleradores para o Brasil envolve tributos, logística e burocracia. O custo final pode ser muito superior ao preço de referência internacional. Isso encarece a compra de hardware próprio e torna a nuvem ou colocation mais atraentes para muitos casos.
Colocation de alta densidade: onde já existe capacidade no país
Alguns provedores de colocation no Brasil já oferecem racks com densidade de 20 a 40 kW, e alguns estão se preparando para mais. Vale a pena consultar a capacidade elétrica e de refrigeração antes de planejar um rack de 100 kW. A oferta ainda é limitada em algumas regiões.
Nuvem pública, privada, híbrida ou colocation: como decidir
Não existe resposta única. Depois de avaliar vários cenários, aprendi a não confiar em promessa de fornecedor: a medição real é o que importa. A escolha depende de três fatores principais: volume de trabalho, exigência de latência e sensibilidade dos dados.
Checklist de sete perguntas antes de fechar a arquitetura
- Qual é a latência máxima aceitável para o usuário final?
- Os dados são sensíveis o suficiente para exigir processamento local?
- Qual é o volume de tokens processados por mês?
- O consumo é previsível ou altamente variável?
- Quanto capital está disponível para investimento inicial?
- Existe equipe técnica para manter o ambiente?
- Qual é o custo total por token em cada cenário?
Erros comuns de dimensionamento e como evitá-los
Superdimensionar refrigeração por ar para racks de 60 kW é erro clássico. O sistema não dará conta e o data center inteiro pode ter que ser desligado. Outro erro é ignorar a redundância de energia, levando a quedas totais.
Para evitar, comece com prova de conceito em menor escala e meça as métricas reais antes de comprometer capital. Planeje para o pico de consumo, não para a média.
Cluster caseiro, estação com GPU e hardware de mineração adaptado
O que funciona para teste e o que não escala em produção
Um cluster caseiro com duas ou quatro placas de vídeo de consumo serve para aprender e testar modelos pequenos. É barato e rápido de montar. Porém, não tem a confiabilidade, a largura de banda de rede nem a dissipação térmica para produção em escala.
Hardware de mineração adaptado para IA raramente vale a pena: as placas têm memória limitada e foram projetadas para outra carga. A economia inicial se perde em dores de cabeça e desempenho inferior.
Para produção, prefira infraestrutura de data center, mesmo que alugada. O custo de um incidente supera qualquer economia caseira.
O tamanho do mercado e o que os números revelam
Gasto global em trajetória de quase triplicar em cinco anos
Projeções de consultorias indicam que o gasto global com infraestrutura de IA está na casa das centenas de bilhões de dólares e pode quase triplicar em cinco anos. Esse crescimento é impulsionado pela migração da IA de laboratório para produção industrial.
O número reflete não apenas a compra de aceleradores, mas também investimentos em energia, refrigeração e software. A infraestrutura virou um dos maiores mercados de tecnologia.
Como medir se a infraestrutura entrega o que promete
Tokens por segundo, uso do acelerador e goodput
Tokens por segundo medem a vazão de inferência. Uso do acelerador indica quanto tempo o chip está ocupado. Goodput é a vazão útil, descontando retransmissões e perdas. As três métricas juntas mostram se a infraestrutura está realmente produzindo valor.
Um cluster pode ter alta utilização, mas se o goodput for baixo, há algo errado na rede ou no software.
Latência, disponibilidade e o efeito direto no SLA
Para serviços em produção, a latência percebida pelo usuário e a disponibilidade do sistema definem o SLA. Se a infraestrutura cai, o SLA é violado e pode haver penalidades contratuais. Por isso, redundância e monitoramento não são luxo, são requisito.
O que observar nos próximos anos
Interconnect óptico, portas de 800G e racks acima de 100 kW
A próxima geração de interconexões ópticas deve empurrar a largura de banda para 800G por porta. Racks com mais de 100 kW podem se tornar comuns, exigindo refrigeração líquida como padrão, não exceção.
Esses avanços permitirão treinar modelos ainda maiores, mas o consumo de energia continuará sendo o grande limitador.
Soberania de dados como decisão de arquitetura, não de jurídico
Cada vez mais, a localização dos dados será definida pelo time de infraestrutura, não apenas pelo departamento jurídico. Regulamentações como a LGPD e leis de proteção de dados em outros países empurram para arquiteturas distribuídas, com processamento perto do usuário e armazenamento em regiões específicas.
Isso muda o desenho da rede e do data center, favorecendo soluções híbridas e colocation local.
Três passos para aplicar esse conhecimento hoje
Guia Rápido · Pontos-Chave
- 01A Escolha Certa: Comece mapeando a latência real da sua aplicação. Se a resposta ao usuário precisa ser instantânea, a inferência deve rodar no Brasil ou em região próxima. Se o volume de tokens mensal for baixo, nuvem pública é a opção mais pragmática.
- 02Ponto de Atenção: Não confunda treinamento com inferência. Treinar é um evento esporádico e caro; inferir é contínuo e cresce com o uso. O custo de infraestrutura ao longo de um ano geralmente é dominado pela inferência, não pelo treino.
- 03Na Prática: Pegue um modelo pequeno, rode-o em uma instância de nuvem com acelerador e meça tokens por segundo, latência e custo por token. Essa experiência empírica vale mais que qualquer leitura e te dá base para dimensionar cenários maiores.
Um insight que raramente é discutido: o custo de um cluster de IA não está no preço do hardware, mas na ineficiência de utilização. Um acelerador ocioso por gargalo de rede é dinheiro sendo queimado a cada segundo. A correção mais barata muitas vezes é redimensionar a rede, não comprar mais chips.
Entender infraestrutura de IA deixou de ser curiosidade técnica. É uma competência estratégica para qualquer profissional que lida com tecnologia, do desenvolvedor ao gestor. Você agora tem um mapa mental claro das sete camadas e sabe onde os gargalos costumam aparecer.
O próximo passo é sair da teoria. Escolha um modelo pequeno, rode um benchmark de inferência em uma nuvem pública e observe as métricas. Compare com a promessa do fornecedor. Dessa prática nasce a intuição para decisões maiores.
A infraestrutura de IA não é mágica. É engenharia. E engenharia se aprende fazendo.
O que pouca gente sabe: O dinheiro vaza em quatro pontos invisíveis: acelerador ocioso por gargalo de rede, rack superdimensionado em refrigeração por ar, inferência rodando longe do usuário e armazenamento lento travando checkpoint. A métrica que revela cada problema é a utilização do acelerador, a densidade térmica real, a latência percebida e o tempo de gravação de checkpoint. Corrija esses pontos e o custo por token cai sem trocar nenhum componente caro.
