
Execução hospedada é o modelo em que seu código roda em um ambiente fornecido, mantido e isolado por terceiros, enquanto você cuida da lógica, das dependências e das permissões. Você abre o painel da nuvem, cola a função de TypeScript, aperta deploy e, em poucos segundos, o endpoint responde. O terminal não mostra qual máquina executou aquilo, nem onde estão os arquivos temporários. Essa sensação de não saber onde o código mora é exatamente o ponto: a execução está hospedada, e a arquitetura foi desenhada para esconder o hardware de propósito.
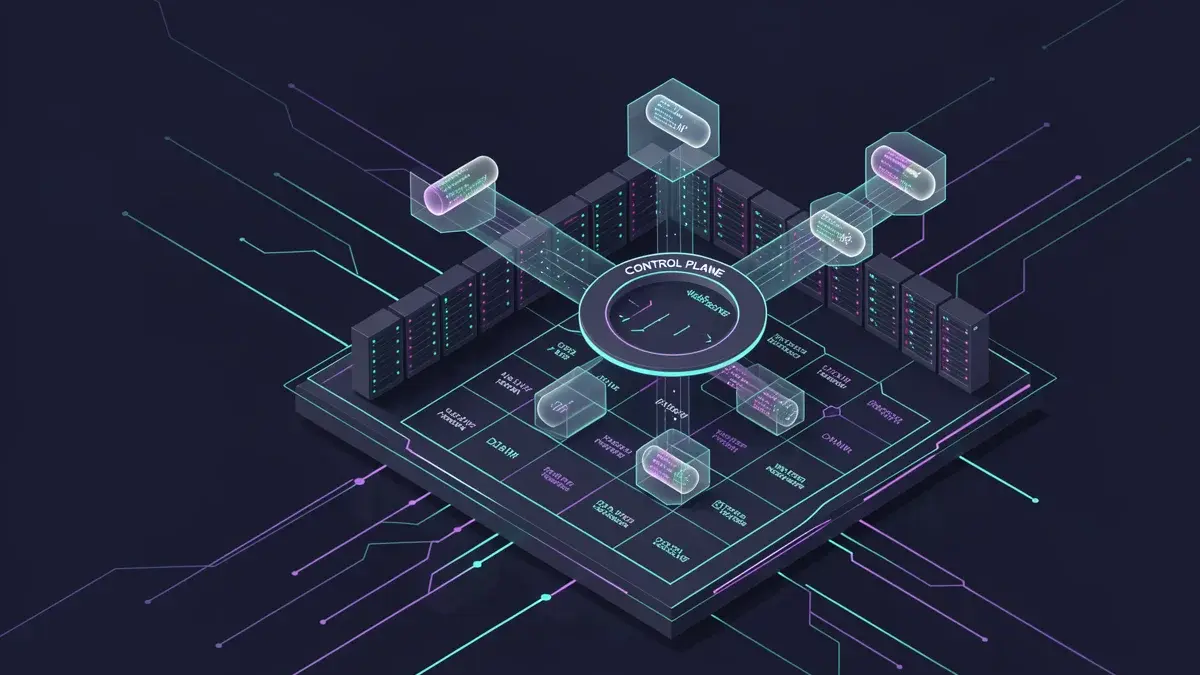
A confusão começa quando a gente tenta encaixar todos os modelos na mesma caixa. Hospedagem compartilhada, máquina virtual alugada, função serverless e sandbox de agente de IA são todos exemplos desse modelo de hospedagem, mas cada um divide a responsabilidade de um jeito. O que muda de verdade é a fronteira entre quem decide e quem executa, conhecida como separação entre plano de controle e plano de dados. Quando essa linha fica clara, a escolha do ambiente deixa de ser aposta e vira projeto.
E há um motivo novo para prestar atenção nisso: código gerado por agente de IA. Quando uma máquina escreve e executa o script, o isolamento entre sessões não é opcional. É a diferença entre um experimento seguro e um vazamento de dados de cliente. É sobre essa fronteira que vamos falar, sem jargão e com comparações do cotidiano.
- Execução hospedada é o modelo em que o código roda em infraestrutura de terceiros, com isolamento e orquestração gerenciados pelo host, enquanto o cliente mantém controle sobre o código e as permissões.
- A separação entre plano de controle (decisão e orquestração) e plano de dados (execução real) é o princípio central que permite sandboxes gerenciados, auto-hospedados e híbridos.
- O isolamento entre execuções pode ser feito por namespaces e cgroups em containers, hipervisor em máquinas virtuais e microVMs, ou isolates de runtime, cada um trocando velocidade de inicialização por força de isolamento.
- Quando o código é gerado por agente de IA, o isolamento por sessão e o controle de saída de rede deixam de ser opcionais, pois o vazamento de estado entre execuções em ambientes multi-tenant é o incidente mais comum.
Vamos ver onde seu código roda, a evolução histórica, os quatro níveis de isolamento e o checklist final antes de subir qualquer execução.
A camada invisível que decide o que acontece com cada requisição
A maioria dos profissionais de TI já usou esse modelo hospedado sem perceber. Quando você publica uma função serverless, cria uma máquina virtual na nuvem ou usa um runner de CI/CD oferecido como serviço, está transferindo parte da operação para um host. A parte que ninguém vê é a camada de orquestração: quem recebe o gatilho, decide qual runtime vai processar, injeta credenciais temporárias e coleta os logs. Essa camada não executa seu código; ela só decide como e onde ele será executado.
Essa divisão explica por que existe sandbox auto-hospedado. Você pode deixar o plano de controle com um fornecedor e manter o plano de dados dentro da sua própria rede. Assim, o sistema de arquivos, os processos e a saída de rede permanecem no seu perímetro, algo essencial para dados sensíveis ou exigências de auditoria. É a diferença entre terceirizar o volante ou terceirizar apenas o mapa.
Antes de escolher qualquer ambiente, pergunte: se eu remover a orquestração externa, o código ainda roda? Se a resposta for não, você está usando execução hospedada, não apenas uma máquina alugada.
O que é execução hospedada: a analogia da cozinha industrial
Nesse modelo, seu código roda em um ambiente fornecido, mantido e isolado por terceiros, chamado de host. Você mantém o controle do código, das dependências e das permissões, mas não administra o servidor, o hipervisor ou o escalonamento. Na prática, é como alugar uma cozinha industrial equipada: você leva a receita e os ingredientes, mas o espaço físico, a limpeza e a manutenção dos equipamentos são do dono.
O funcionamento depende de uma fronteira precisa entre plano de controle e plano de dados. O plano de controle recebe a requisição, decide em qual runtime executar, injeta credenciais temporárias e coleta métricas. O plano de dados é onde o código roda de verdade, com CPU, memória e acesso à rede. Quando você usa uma função serverless, o plano de controle fica no serviço de nuvem; o plano de dados pode estar em um pool de runtimes gerenciados ou, em cenários auto-hospedados, dentro da sua própria conta.
Para que serve? Para rodar código que responde a eventos ou tráfego sem que você precise provisionar capacidade fixa. Serve para APIs, tarefas agendadas, processamento de filas, webhooks e, cada vez mais, para executar trechos de código gerados por modelos de linguagem com segurança. Os benefícios são diretos: você elimina manutenção de servidor, ganha escalabilidade automática, reduz superfície de ataque e paga pelo que usa, embora o custo exija atenção.
As principais características de um ambiente de execução hospedada incluem isolamento por sessão, inicialização rápida, teto de tempo por execução, memória configurável e descarte automático do sistema de arquivos após o término. Tudo isso existe para que dezenas de execuções de clientes diferentes possam dividir a mesma máquina física sem se enxergarem.
A evolução da execução hospedada: do mainframe aos sandboxes de IA
Esse modelo não nasceu com a nuvem; ele aparece já no tempo compartilhado de mainframes, quando terminais burros enviavam jobs para um computador central que fazia todo o trabalho. Nos anos seguintes, provedores de aplicação entregavam software rodando em servidor alheio; depois vieram a hospedagem compartilhada, a máquina virtual alugada e a nuvem elástica. Cada etapa reduziu a responsabilidade do cliente sobre o hardware e aumentou a abstração.
A virada recente é mais sutil: o plano de controle passou a ficar separado do plano de dados. Isso permitiu que um agente de IA escreva código em um serviço de nuvem enquanto executa esse código dentro da rede da própria empresa. Hoje, a execução hospedada aparece em sandboxes de agentes de IA, runtimes de borda com isolates leves, runners de integração contínua e plataformas que transformam arquivos de código em endpoints. Em todos esses casos, o padrão é o mesmo: o host cuida da infraestrutura efêmera, enquanto você cuida do que o código faz e de quais recursos ele pode tocar.
Como funciona o isolamento entre sessões
Isolamento entre sessões é a capacidade de garantir que uma execução não consiga ler dados ou interferir no ambiente de outra, mesmo quando ambas rodam no mesmo servidor físico. Existem quatro níveis principais de isolamento. O primeiro é o processo, com namespaces e cgroups do Linux separando recursos, mas ainda compartilhando o kernel. O segundo é o container, que empacota o processo com imagem, sistema de arquivos próprio e limites de recursos. O terceiro é a microVM, com hipervisor KVM ou Firecracker criando uma máquina virtual mínima, com kernel convidado; é mais forte, porém com partida mais lenta. O quarto é o isolate, como no V8 ou WebAssembly, que isola no nível do runtime, sem sistema operacional próprio: extremamente rápido, mas com proteção mais limitada contra código que explora o runtime. Cada camada troca velocidade de inicialização por força de isolamento.
Em ambientes multi-tenant, o erro mais comum não é desempenho, é vazamento de estado: um cache compartilhado ou uma credencial reaproveitada entre sessões pode expor dados de um cliente a outro. Na minha leitura, essa combinação é o que separa um sandbox confiável de um risco silencioso. Por isso, o isolamento precisa vir acompanhado de gestão de identidade por sessão e controle de egress de rede. Sem isso, mesmo o isolamento mais forte não impede que um código com permissão ampla cause dano.
Confesso que demorei a levar a sério a diferença entre isolamento por container e isolamento por microVM. Achava que bastava escolher o mais rápido e pronto. O problema apareceu quando um time quis executar código gerado por agente de IA dentro da rede da empresa, com dados de produção. O runtime escolhido inicializava em milissegundos, mas um script malicioso conseguiu acessar um arquivo de cache compartilhado entre execuções. Não houve invasão sofisticada; foi só um diretório mal configurado. A partir daí, comecei a tratar sandbox de execução como um contrato de responsabilidade dividida, não como uma opção de infraestrutura. A pergunta que guia minhas escolhas agora é simples: qual o pior dano possível se esse código escapar do isolamento? Se a resposta envolver dados de terceiros ou credenciais reutilizáveis, a camada de isolamento sobe, não desce. É essa mentalidade que aplico nas dicas a seguir, porque no fim das contas o custo de um vazamento de estado entre sessões supera qualquer ganho de cold start.
Boas práticas para adotar o modelo hospedado no dia a dia
A primeira dica prática é mapear a fronteira de responsabilidade antes de escrever uma linha de configuração. Defina onde fica o plano de controle, onde fica o plano de dados e quem pode acessar cada um. Em cargas simples, use isolate para respostas rápidas e sem estado. Em cargas que tocam banco de dados ou sistema de arquivos, suba para container ou microVM, com credenciais de curta duração e disco descartável. Eu prefiro desenhar essa fronteira em um quadro antes de tocar em qualquer configuração; é o tipo de passo que evita retrabalho e discussão sobre responsabilidade.
Limitações comuns incluem cold start, timeout de execução, concorrência limite e throttle quando o serviço atinge o teto de invocações por segundo. Esses limites não são defeitos: são o preço do isolamento e da escalabilidade automática. O cuidado crítico é a saída de rede: sem uma política de egress, um código com acesso amplo pode vazar dados para fora ou chamar serviços não autorizados. Em território brasileiro, a LGPD impõe que você saiba onde os dados são processados e por quanto tempo são retidos; verifique a região de execução e configure retenção de logs mínima.
Uma dúvida frequente é se o modelo hospedado serve para produção. Serve, desde que você trate o ambiente como efêmero e idempotente. Aplicações que dependem de estado local fixo, sessão longa ou acesso irrestrito ao sistema de arquivos vão sofrer; mas APIs sem estado, processamento assíncrono e integrações de curta duração funcionam bem.
Erros comuns e como evitá-los
O erro número um em ambiente multi-tenant é reaproveitar credenciais entre execuções. Se duas sessões usam a mesma chave de API ou o mesmo token de banco, um vazamento em uma expõe a outra. Na minha leitura, é o erro mais subestimado porque parece inofensivo até o primeiro incidente. A correção é gerar credencial temporária por execução, com escopo mínimo e validade de poucos minutos.
O segundo erro é ignorar o descarte do sistema de arquivos. Muitos ambientes prometem disco efêmero, mas se o código grava algo em um volume compartilhado ou em um cache global, o estado vaza. A regra é: nada de estado persistente fora do banco ou de um armazenamento explicitamente autorizado. Terceiro erro comum: não configurar timeout e memória, o que transforma uma execução lenta em custo contínuo ou em throttle para todos os clientes do mesmo pool. Defina tetos realistas e monitore o percentual de timeouts.
Outro mito é achar que microVM é sempre mais segura que container. A microVM protege melhor contra fuga de kernel, mas se você abrir a rede e compartilhar credenciais, a segurança extra não serve de nada. A camada de isolamento é necessária, não suficiente.
Checklist de preparação antes de subir código em ambiente multi-tenant
Na Prática · O Que Fica
- 01A Escolha Certa: Defina o isolamento pela sensibilidade do dado, não pelo hype. Cargas sem estado e de baixo risco podem usar isolate; dados de terceiros pedem container ou microVM com credenciais por sessão.
- 02Ponto de Atenção: Execução hospedada não é sinônimo de serverless. PaaS, máquina virtual alugada e sandbox de agente de IA são variações do mesmo conceito, e cada uma tem uma fronteira de responsabilidade diferente.
- 03Na Prática: Antes de subir qualquer código, liste todas as saídas de rede necessárias e bloqueie o resto com política de egress. Depois, configure credencial temporária por execução e verifique se não há cache ou disco compartilhado entre sessões.
O que poucos textos explicam é que a separação entre plano de controle e plano de dados é o que torna possível o sandbox auto-hospedado. A orquestração pode ficar em um fornecedor, mas o sistema de arquivos, os processos e a saída de rede permanecem na sua infraestrutura. Não é apenas sobre onde o código roda, mas sobre quem decide e quem executa. Confesso que demorei a perceber essa flexibilidade; hoje acho essa separação uma das decisões mais subestimadas do desenho de arquitetura.
Se você chegou até aqui, entendeu que o modelo hospedado não é sobre delegar o controle, mas sobre dividir responsabilidades de forma deliberada. O host cuida da infraestrutura efêmera; você cuida do que o código faz, de quais recursos ele pode tocar e de como os dados são tratados. Na minha visão, é essa clareza que separa um time que só consome nuvem de um time que projeta arquitetura.
Comece pequeno: pegue uma função que hoje roda em um servidor fixo e faça um teste de execução isolada por sessão. Observe o cold start, configure timeout e bloqueie saída de rede não essencial. Depois, documente a fronteira entre plano de controle e plano de dados no seu time. O código que roda longe dos seus olhos não precisa ser uma caixa-preta; precisa ser um ambiente com fronteiras claras. E agora você sabe desenhar essas fronteiras.
O que pouca gente sabe: A escolha errada de isolamento costuma doer mais por causa do estado do que da velocidade. Um isolate inicializa em dezenas de milissegundos, mas se você compartilhar um cache entre sessões, a agilidade não compensa o risco de vazar dados de uma execução para outra.
