
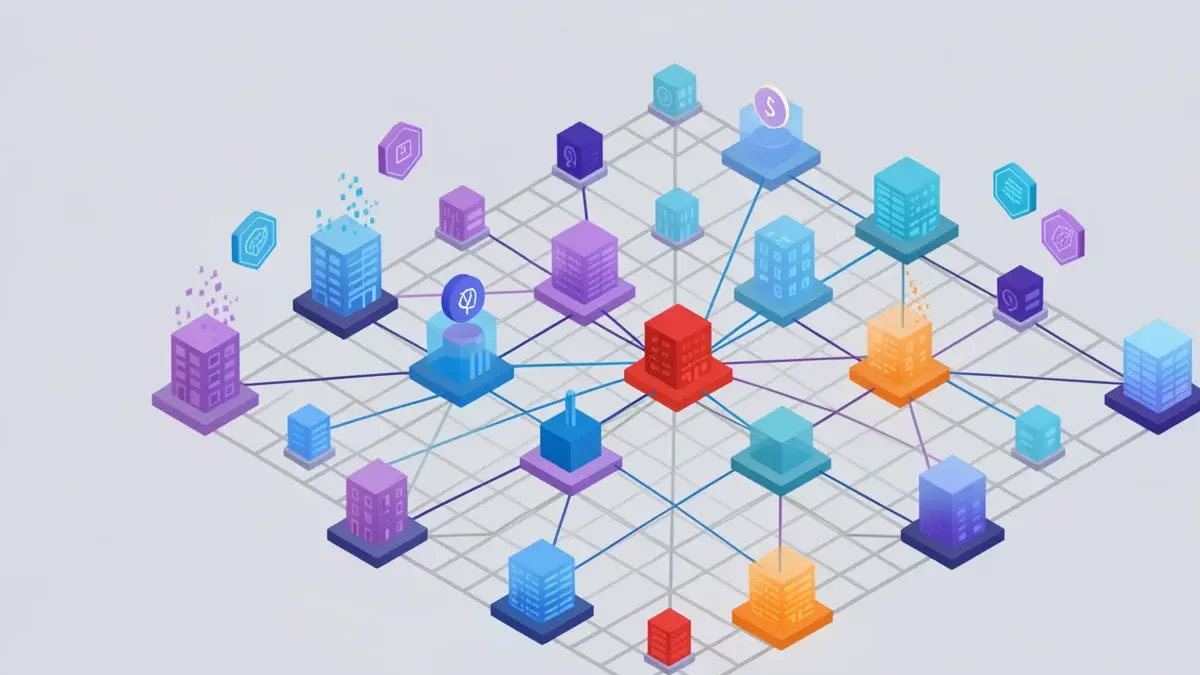
Múltiplos agentes é a arquitetura que divide uma tarefa complexa entre vários agentes de IA especializados, com um orquestrador planejando, delegando, verificando e agregando resultados. O erro mais comum é achar que um agente único resolve qualquer problema — e é justamente essa crença que faz projetos travarem. Um agente só mistura contextos, estoura tokens e não termina tarefas longas; a coordenação de múltiplos agentes resolve isso isolando contexto e especializando papéis, mas cobra um preço em overhead que poucos calculam antes de codar.
A maioria dos times pula para multiagente sem medir o custo real de coordenação. Esse custo aparece em três frentes: tokens adicionais para cada handoff, latência percebida pelo usuário e complexidade para depurar uma cadeia de decisões. Em um cenário típico, um sistema multiagente pode consumir de cinco a quinze vezes mais tokens do que uma conversa única com o mesmo modelo. Se a conta é em dólar, a surpresa no fim do mês não é técnica: é financeira.
A diferença entre um sistema que falha e um que produz de verdade está no desenho dessa coordenação. Não se trata de adicionar agentes por adicionar, mas de entender quando vale a pena paralelizar, serializar ou simplesmente manter tudo em um agente único com boas ferramentas. É sobre esse desenho — arquitetura, padrões, frameworks e o tal custo que ninguém coloca na planilha — que a gente vai conversar agora.
- Sistema multiagente é uma arquitetura em que dois ou mais agentes de IA, cada um com prompt, ferramentas, memória e janela de contexto próprios, cooperam para cumprir um objetivo comum.
- O ganho vem de isolamento de contexto, paralelização e especialização de papel; o custo vem do overhead de coordenação, que consome de 5 a 15 vezes mais tokens do que uma conversa única.
- Padrões de arquitetura essenciais incluem orquestrador-worker, pipeline sequencial, paralelo com módulos disjuntos, hierárquico com supervisor e enxame com handoffs dinâmicos.
- Ferramentas como MCP e A2A simplificam integração e comunicação entre agentes; frameworks como LangGraph, CrewAI, AutoGen e n8n dominam o mercado brasileiro.
- Tarefas simples, sequenciais ou com baixa independência não precisam de múltiplos agentes; o custo e a latência podem inviabilizar o retorno, então a decisão deve começar pelo desenho da tarefa, não pela vontade de usar a arquitetura.
- A anatomia de um time de agentes: orquestrador, subagentes e o fluxo de handoff na prática.
- Os quatro padrões de arquitetura que sustentam sistemas multiagente em produção — e quando escolher cada um.
- O custo real em tokens e latência: como medir antes de multiplicar agentes e estourar o orçamento.
- Quando um agente único ainda é a melhor resposta: sinais de que multiagente é exagero no seu caso.
Multiagente: o ponto cego que afunda times de IA
Um sistema multiagente parece simples no diagrama: um orquestrador, alguns especialistas e setas de handoff. Na prática, essa aparente simplicidade esconde camadas de complexidade que raramente aparecem no primeiro MVP. O gargalo quase nunca está na capacidade do modelo, mas na coordenação entre as peças — e é aí que times experientes travam.
O que pouca gente percebe é que a ideia de múltiplos agentes não nasceu com os LLMs. A academia já explorava sistemas multiagente distribuídos há décadas, com linguagens como KQML e FIPA-ACL, plataformas como JADE e o modelo de atores de Erlang e Akka. O que mudou foi o motor de raciocínio: modelos de linguagem agora conseguem planejar, chamar ferramentas e se autocorrigir. Esse salto tornou viável montar equipes de agentes em software de produção, mas trouxe junto um custo de coordenação que a teoria clássica nunca precisou pagar — tokens, latência e depuração em cadeia.
Antes de criar um orquestrador, escreva o fluxo da tarefa em passos claros. Se houver paralelismo real entre eles, vale dividir. Se for uma cadeia linear, um agente único com bom tool calling resolve mais barato.
Múltiplos agentes: como arquitetar um time de IA que entrega de verdade
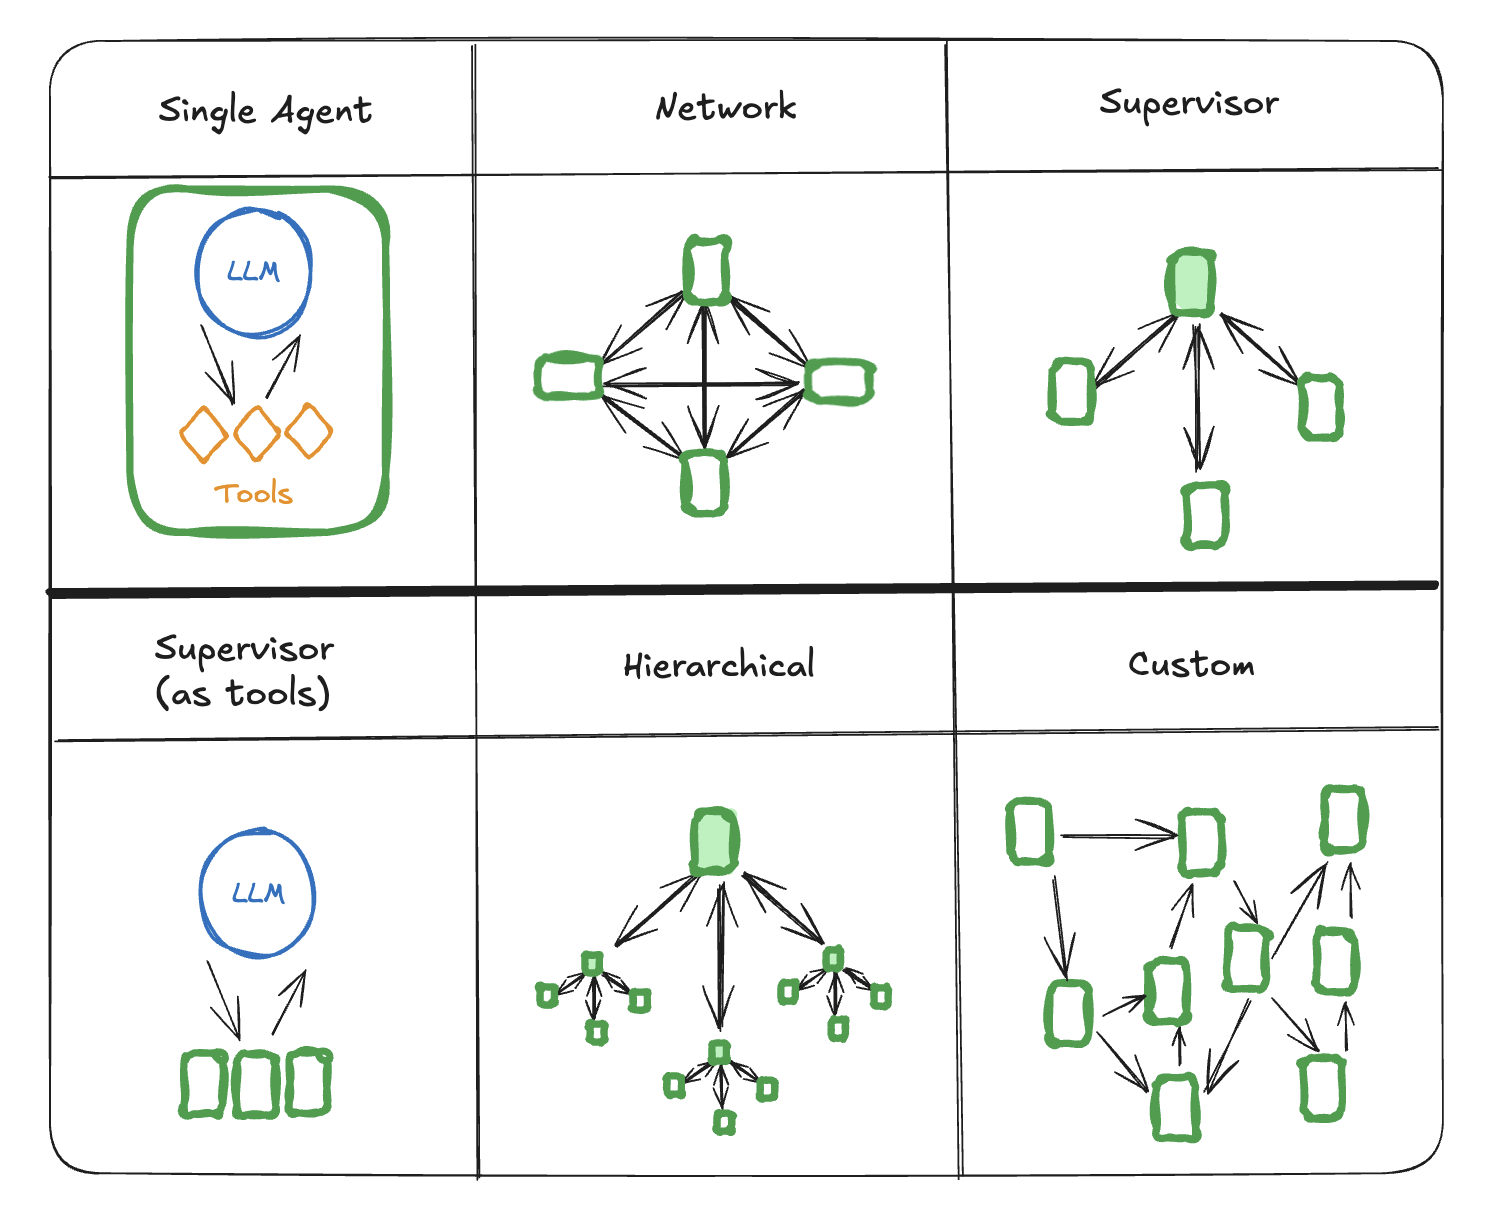
Sistema multiagente é uma arquitetura em que dois ou mais agentes de IA, cada um com prompt, ferramentas, memória e janela de contexto próprios, cooperam para cumprir um objetivo comum. Diferente de um agente único, que tenta resolver tudo em uma única conversa, um sistema multiagente decompõe a tarefa em subtarefas e distribui entre especialistas. Já um workflow comum é uma sequência fixa de passos, enquanto o multiagente permite decisões dinâmicas e delegação baseada em contexto.
O coração dessa arquitetura é o orquestrador. Ele não faz todo o trabalho; ele planeja, escolhe qual subagente acionar, faz handoff com contexto cirúrgico e depois verifica se o resultado parcial atende ao critério. Cada subagente tem sua própria janela de contexto, então um erro de interpretação em um não contamina os demais. Essa é a característica mais valiosa: isolamento de contexto.
Outras características definem um time de agentes: especialização de papel, execução paralela, memória de curto e longo prazo, e pontos de checkpoint para retomar de onde parou. Esses elementos formam a base sobre a qual os padrões de arquitetura operam.
Múltiplos agentes na prática: padrões, frameworks e o custo real em tokens
Padrões de arquitetura para múltiplos agentes
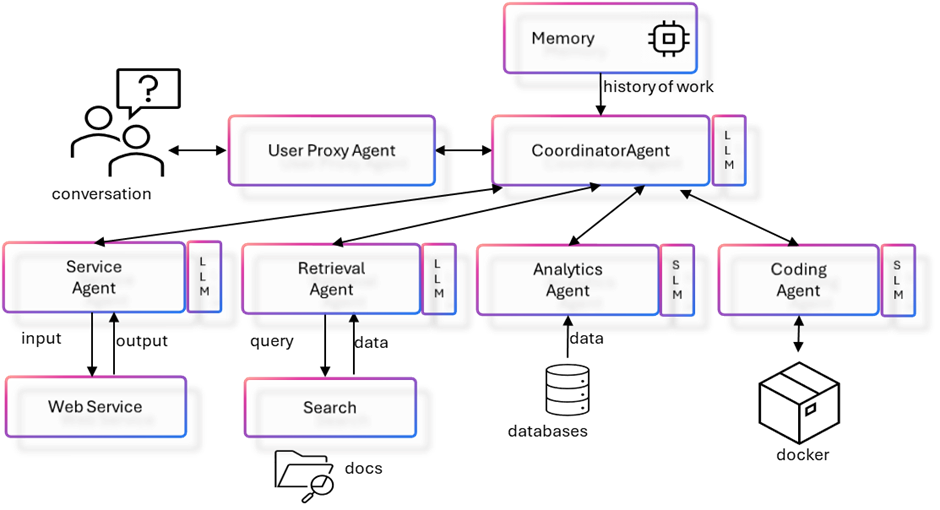
Os padrões mais usados em produção são orquestrador-worker, pipeline sequencial, paralelo com módulos disjuntos, hierárquico com supervisor e enxame com handoffs dinâmicos. Cada um resolve um tipo de tarefa e tem um trade-off claro em custo, latência e complexidade.
Orquestrador-worker é o mais comum: um agente central planeja e delega tarefas a workers especializados, cada um com seu domínio. Funciona bem para atendimento ao cliente com especialistas por assunto; o trade-off é a dependência do orquestrador, que vira ponto único de falha.
Pipeline sequencial encadeia agentes em ordem fixa: um implementa, outro revisa, outro corrige. É o padrão para geração de código com revisor. A vantagem é previsibilidade; a desvantagem é que a latência soma cada etapa, e um erro no início se propaga.
Paralelo com módulos disjuntos divide a tarefa em partes independentes que rodam ao mesmo tempo. Pesquisa profunda com vários investigadores é o exemplo clássico. Quando as tarefas são realmente independentes, times brasileiros medem queda de 40% a 60% na latência total. O risco é o conflito de escrita em recursos compartilhados, como dois agentes editando o mesmo arquivo.
Hierárquico com supervisor insere um nível de supervisão acima dos orquestradores, útil quando há domínios muito distintos que não devem se misturar. O custo extra é que cada camada adiciona tokens e tempo de coordenação.
Enxame de agentes usa handoffs dinâmicos sem orquestrador fixo: os agentes conversam entre si e passam o contexto conforme a tarefa flui. Claude Code popularizou subagentes com contexto cirúrgico e orquestrador que só gerencia. A flexibilidade é alta, mas a previsibilidade cai e a depuração fica mais difícil.
Frameworks e ferramentas de orquestração
No mercado atual, LangGraph domina para quem precisa de grafos com estado, checkpoint e intervenção humana. CrewAI é a porta de entrada para times de agentes baseados em papéis. AutoGen, unificado com Semantic Kernel, traz o ecossistema Microsoft. OpenAI Agents SDK oferece handoffs nativos. n8n virou a opção low-code para pequenas empresas brasileiras que querem automação multiagente sem código pesado.
A escolha depende do tipo de projeto e do time. Se a equipe é de engenharia e precisa de controle fino sobre o fluxo, LangGraph faz sentido. Se é uma consultoria querendo entregar rápido, CrewAI acelera. Se o negócio é automação de processos com pouca lógica condicional, n8n resolve sem um time de engenheiros. O ponto que define a decisão é a curva de depuração: quanto mais dinâmico o grafo, mais ferramentas de observabilidade e tracing você vai precisar.
O custo real em tokens e latência
O preço da coordenação aparece primeiro na conta de tokens. Um agente individual já gasta em média quatro vezes mais tokens que uma conversa simples. Em um sistema multiagente, cada subagente adicional soma overhead de ida e volta nas mensagens. Relatos de engenharia de fornecedores de modelos indicam que um sistema de pesquisa multiagente superou a versão de agente único em cerca de 90% em avaliação interna, consumindo aproximadamente 15 vezes mais tokens que um chat comum. Em cenários reais, o overhead de coordenação costuma ficar entre cinco e quinze vezes.
Isso significa que, antes de dividir em múltiplos agentes, você precisa estimar quantas chamadas de modelo serão necessárias. Se a tarefa pode ser resolvida com três chamadas de agente único e passaria a exigir vinte chamadas no multiagente, o ganho de qualidade precisa justificar essa multiplicação. Para times brasileiros, onde a conta de API é em dólar, essa aritmética não é opcional: é a diferença entre um projeto sustentável e um que estoura o orçamento.
Latência também pesa. Quando tarefas são realmente independentes, o paralelismo reduz o tempo total. Quando há dependência, a soma das etapas pode deixar o sistema mais lento que um agente único. O equilíbrio está em identificar onde o paralelismo é real e onde ele é apenas uma ilusão de eficiência.
Múltiplos agentes: quando um agente só já não dá conta do recado
A necessidade de múltiplos agentes surge quando a tarefa é grande demais para uma única janela de contexto, exige conhecimentos especializados em domínios diferentes ou tem partes naturalmente paralelas. Um agente único tentando revisar um pull request, extrair dados de contratos e redigir uma resposta ao cliente ao mesmo tempo vai misturar contextos e falhar em todas as frentes.
Na prática brasileira, os casos que mais justificam multiagente são: revisão automática de pull request com agente revisor, pesquisa profunda com investigadores em paralelo, atendimento com especialistas por domínio, pipeline de dados com extrator, validador e carregador, triagem de contratos jurídicos e monitoramento de infraestrutura com investigador e remediação. O denominador comum é a divisão clara de responsabilidades e a possibilidade de rodar etapas ao mesmo tempo.
Os benefícios desse desenho são concretos: o isolamento de contexto impede que erros de um domínio contaminem outro, a especialização melhora a qualidade por tarefa e a paralelização reduz o tempo de resposta quando a independência existe. O custo, como descrito, é o overhead de coordenação — e é isso que leva ao próximo ponto.
Eu já vi times quebrar a cabeça com multiagente não porque escolheram o framework errado, mas porque nunca pararam para medir o overhead de coordenação. No primeiro teste, o sistema funcionava: qualidade boa, respostas coerentes. No segundo mês, a conta de tokens veio com um número que assustou, e o tracing mostrou que os agentes estavam repetindo passos, reiniciando loops e trocando contextos sem necessidade. O problema não era a arquitetura, era a falta de limites explícitos. Isso mudou minha abordagem: hoje eu não desenho um time de agentes sem antes definir o orçamento de tokens por tarefa e o número máximo de iterações.
Essa percepção me levou a organizar as dicas práticas a seguir, focadas em evitar que você passe pelo mesmo susto.
Dicas práticas para aproveitar múltiplos agentes no dia a dia
Antes de codar, desenhe o fluxo em papel ou em texto simples. Liste cada etapa, identifique dependências e marque onde há paralelismo real. Essa etapa barata evita o erro clássico de montar um time de agentes para uma tarefa que um agente único com boas ferramentas faria melhor.
Uma limitação central do multiagente é a dificuldade de depuração. Quando cada agente tem seu próprio contexto, rastrear onde a decisão saiu errada exige ferramentas de tracing que registrem cada passo. Sem isso, você fica às cegas. A dica é integrar observabilidade desde o primeiro dia, não depois que o problema aparece.
Outro cuidado crítico é a segurança. Dar ferramentas a vários agentes multiplica a superfície de ataque para prompt injection. Um agente pode receber instruções maliciosas de uma página web e repassá-las ao orquestrador, iniciando uma cadeia de exfiltração de dados. Isolar permissões, rodar código em sandbox e validar saídas antes de executar ações irreversíveis são práticas obrigatórias.
Dúvidas comuns surgem nesse ponto. Quanto custa rodar em produção? Depende do número de chamadas, mas a referência dos dados do setor é que o custo de infraestrutura doméstica é baixo, e o que pesa é a conta de tokens em dólar. Dá para rodar com modelo aberto local? Sim, e para times brasileiros essa é uma forma de reduzir dependência cambial, mas exige GPUs locais e a qualidade pode cair em tarefas complexas. Como saber se o time de agentes está funcionando? Use evals por passo: defina métricas de qualidade para cada agente individual, não só para o resultado final.
Curiosidade que poucos conhecem: o conceito de enxame de agentes veio da robótica de enxame, onde robôs simples coordenam por regras locais. Em software, isso se traduz em handoffs dinâmicos sem orquestrador fixo, o que aumenta a flexibilidade mas reduz a previsibilidade. É um exemplo de como ideias antigas encontram nova vida nos LLMs.
Erros comuns e como evitá-los
O primeiro erro é não limitar iterações. Um orquestrador insistente pode entrar em loop, gastando tokens sem convergir. Defina um teto de iterações por tarefa e um orçamento de tokens máximo.
O segundo é ignorar o isolamento de contexto. Dois agentes que compartilham estado podem se contradizer: um altera uma variável que o outro já leu. Use filas de mensagens e checkpoints para garantir consistência.
O terceiro é tratar a saída de um agente como verdade absoluta. Sem um revisor ou human-in-the-loop, erros se propagam e se multiplicam. Inclua um passo de validação humana em decisões críticas.
O quarto é não testar com evals. Um time de agentes sem métricas por etapa é uma caixa preta: você não sabe se a melhora veio do orquestrador, do subagente ou do acaso. Crie evals curtos para cada papel.
O quinto erro é achar que multiagente substitui arquitetura de software robusta. Filas, cache e retry ainda são necessários; os agentes são apenas mais um nó no sistema, não a solução de infraestrutura.
Múltiplos agentes sob controle: o plano de ação para começar bem
Na Prática · O Que Fica
- 01A Escolha Certa: Desenhe o fluxo antes de escolher a arquitetura. Se houver três etapas independentes e um erro em uma não afeta as outras, use paralelismo com orquestrador. Se for sequencial com revisão, pipeline. Se for uma única tarefa, agente único.
- 02Ponto de Atenção: O custo de coordenação não é linear. Adicionar um segundo agente pode dobrar a conta de tokens, e o terceiro pode triplicar. Calcule o multiplicador antes de codar, não depois da fatura.
- 03Na Prática: Hoje, pegue uma tarefa real que você resolveria com um agente. Escreva os passos, marque dependências e estime quantas chamadas de API cada abordagem exigiria. Compare os números e decida com base em evidência, não em tendência.
Uma tabela de decisão mental que uso antes de qualquer implementação cruza três variáveis: número de etapas, independência entre as partes e criticidade do erro. Se a tarefa tem até três etapas, alta dependência e erro tolerável, agente único resolve. Se tem mais de cinco etapas, partes independentes e erro crítico, pipeline sequencial com revisor. Se tem muitas sub-tarefas paralelas e erro crítico isolável, orquestração com paralelismo. E sempre multiplique o número estimado de chamadas por quatro para ter o piso real de tokens. Essa conta simples evita a surpresa que assombra times de TI no Brasil.
Múltiplos agentes não são uma moda passageira, mas também não são a resposta para todo problema. O domínio dessa arquitetura está em saber quando a divisão de tarefas entrega valor real e quando ela apenas infla a complexidade e a conta de tokens. Você agora tem os critérios para separar um caso do outro: desenho do fluxo, medição de overhead, padrões de arquitetura e instrumentos de confiabilidade.
Comece pequeno. Escolha uma tarefa onde o paralelismo é evidente e monte um sistema com dois ou três agentes, aplicando os limites de iteração e as práticas de segurança descritas. Meça o custo real, compare com o agente único e deixe os dados decidirem o próximo passo. Não existe atalho: a maturidade em multiagente se constrói experimentando, medindo e ajustando.
O que pouca gente sabe: Dois agentes editando o mesmo arquivo ao mesmo tempo podem corromper o código sem gerar erro aparente. O conflito de escrita em recursos compartilhados é um dos riscos silenciosos do paralelismo, e a solução não é evitar paralelizar, mas desenhar módulos disjuntos e usar filas ou locks para serializar a escrita.
