
Orquestração de agentes é a camada de coordenação que define quem faz o quê, em qual ordem, com qual contexto e sob quais limites quando vários agentes de IA trabalham na mesma tarefa.
Muita gente escuta sobre agentes de IA o tempo todo, vê a sigla em tudo quanto é post e sente que está ficando de fora. A promessa é tentadora: em vez de um único modelo generalista tentando resolver tudo, o trabalho é dividido em subtarefas, cada uma encaminhada ao agente mais adequado. Mas a maioria das equipes descobre tarde demais que o custo dessa coordenação não está na sofisticação dos agentes, e sim na cola invisível entre eles.
É exatamente essa cola que separa um sistema que entrega valor de um espetáculo de demos que não sobrevive à primeira semana de produção. Entender como ela funciona, onde quebra e quando não usar é a habilidade que falta para conversar com um time técnico sem se sentir perdido.
- Orquestração de agentes é a camada de coordenação que divide uma tarefa em subtarefas, encaminha cada uma ao agente mais adequado, passa contexto explicitamente e sintetiza o resultado final.
- A diferença central em relação à automação tradicional é que os agentes são componentes probabilísticos: o mesmo pedido pode gerar respostas diferentes, exigindo tratamento de falha, retentativa e observabilidade.
- O padrão envolve papéis como orquestrador, agente supervisor, agente worker e human-in-the-loop, com passagem de contexto via handoff, estado compartilhado ou memória de agente.
- Entre os custos ocultos estão consumo de tokens extra, latência acumulada, laços infinitos e degradação de contexto, além da necessidade de rastreabilidade para atender à LGPD.
- O que é orquestração de agentes e por que ela deixou de ser um detalhe técnico para virar uma camada própria de arquitetura.
- Os papéis concretos dentro de um fluxo multiagente, do orquestrador ao agente worker, sem mistério.
- O custo invisível da coordenação: tokens, latência, loops infinitos e como evitar a armadilha de achar que mais agentes resolvem mais.
- Um roteiro realista de estudo e prática para quem quer atuar com isso no Brasil, do piloto mínimo à produção.
A camada que separa um amontoado de agentes de um sistema que funciona
A ideia de dividir trabalho entre especialistas não é nova. Antes da IA, a coordenação entre componentes de software já existia em arquiteturas orientadas a serviço, barramentos de integração e motores de fluxo de trabalho. A diferença é que, agora, o trabalhador que executa a tarefa não segue um script determinístico: ele decide, interpreta e pode divergir a cada chamada.
Essa mudança transforma a coordenação em um problema de engenharia real. Quando um agente chama uma ferramenta, é preciso garantir que a ferramenta certa foi escolhida. Quando dois agentes trocam mensagens, é preciso definir o que cada um sabe, o que esquece e como a falha de um não derruba o fluxo inteiro. A camada de coordenação passou a ser tão importante quanto o modelo de linguagem que alimenta cada agente.
O erro mais comum é tratar a orquestração como um detalhe de implementação e não como uma decisão de arquitetura. Equipes que ignoram essa camada acabam com agentes competentes presos em correntes frágeis, sem observabilidade e sem controle de custo.
Antes de adicionar um segundo agente, pergunte se a tarefa realmente exige julgamento ambíguo. Se a resposta for não, um fluxo determinístico resolve mais barato.
O que é orquestração de agentes — e por que ela virou uma camada própria na arquitetura
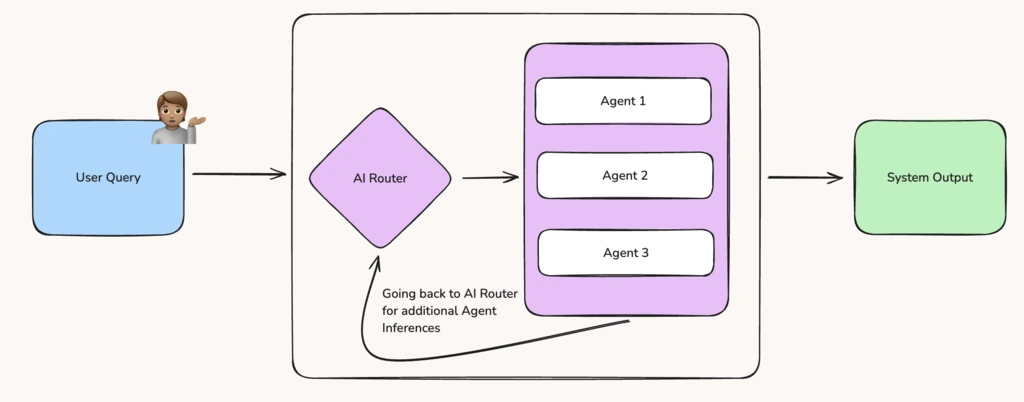
Orquestração de agentes é a coordenação explícita de múltiplos agentes de IA para executar uma tarefa que nenhum deles conseguiria sozinho com a mesma qualidade, custo ou velocidade. Em vez de um único modelo generalista tentando resolver tudo, o trabalho é dividido em subtarefas, cada uma encaminhada ao agente mais adequado, com passagem explícita de contexto, tratamento de falha e síntese final do resultado.
Ela virou uma camada própria porque os agentes são componentes probabilísticos: a mesma entrada pode gerar saídas diferentes. A coordenação precisa lidar com essa variação, com retentativas, com observabilidade e com custo por token. Nenhum framework de aplicação tradicional resolve isso sozinho.
Um pedido, vários especialistas: como o trabalho é dividido em subtarefas
O trabalho é dividido em subtarefas a partir de uma análise de intenção e do domínio de especialidade de cada agente, feita pelo orquestrador. Primeiro, identifica-se o objetivo; depois, quebra-se em passos menores; por fim, cada passo é atribuído ao agente que tem as ferramentas e o contexto adequados.
Um pedido de análise de contrato, por exemplo, pode ser dividido em extração de cláusulas, comparação com um modelo de referência e redação de um resumo executivo. Cada subtarefa exige um tipo de raciocínio e um conjunto de ferramentas específico, justificando especialistas diferentes.
Orquestração de agentes x automação de fluxo comum: onde a diferença realmente aparece
A diferença aparece na capacidade de lidar com ambiguidade e variação sem regras pré-programadas para cada caso. A automação de fluxo comum executa passos determinísticos: se A, então B. A orquestração de agentes decide qual caminho seguir com base em linguagem natural, contexto e probabilidade.
Na prática, um fluxo tradicional de atendimento pode encaminhar um chamado para a fila certa com base em um menu de opções. Um sistema com orquestração agêntica interpreta a mensagem do cliente, identifica a intenção mesmo com erros de digitação, decide se precisa de mais dados e só então roteia para o agente especialista.
Por que o mesmo pedido pode gerar respostas diferentes a cada execução
O mesmo pedido pode gerar respostas diferentes porque cada agente é um modelo probabilístico, amostrando do espaço de linguagem com base em contexto, temperatura e histórico. Não há um caminho único e determinístico; o modelo escolhe a próxima palavra mais provável, e pequenas variações se acumulam.
Essa característica exige que a orquestração trate a saída como uma hipótese, não como um fato. Daí a importância de guardrails, validação cruzada e intervenção humana em pontos críticos.
A coordenação entre componentes de software não nasceu com a IA
A coordenação entre componentes de software é um campo antigo, com raízes em arquiteturas orientadas a serviço, modelagem de processos e concorrência distribuída. A novidade da IA não é a ideia de dividir trabalho, mas o tipo de trabalhador que executa cada parte.
SOA, BPMN e o modelo de atores: as raízes da orquestração
SOA e barramentos de serviço já separavam responsabilidades entre sistemas; o BPMN desenhava processos com raias e donos; o modelo de atores resolveu concorrência distribuída. Essas abordagens tratavam componentes determinísticos, onde a saída era previsível a partir da entrada.
O que a orquestração de agentes herda dessas raízes é a separação de responsabilidades e a passagem explícita de mensagens. O que muda é que o conteúdo dessas mensagens deixou de ser estruturado e passou a ser linguagem natural, sujeita a interpretação.
Arquitetura blackboard: especialistas cooperando sobre um estado comum
A arquitetura blackboard organizava especialistas cooperando sobre um estado comum, onde cada um contribuía quando seu conhecimento fosse relevante. Não havia um mestre central; o estado compartilhado agia como a memória coletiva da solução.
Na orquestração de agentes, o estado compartilhado cumpre papel semelhante, mas com o desafio de que cada agente pode ler e escrever de forma inconsistente. Por isso, muitos fluxos usam handoff de contexto explícito em vez de depender apenas do blackboard.
O que muda quando o componente que executa passa a ser probabilístico
Quando o componente que executa passou a ser probabilístico, a coordenação deixou de ser apenas sequenciar passos e passou a lidar com incerteza, falha e variação de resposta. Um agente pode errar a intenção, chamar a ferramenta errada ou gerar uma resposta factualmente incorreta.
Isso obriga a camada de coordenação a incluir validação, retentativa, observabilidade e pontos de contenção. A arquitetura precisa aceitar que nem sempre o fluxo chegará ao fim, e deve degradar graciosamente.
Quem faz o quê: os papéis dentro de uma arquitetura multiagente
Em uma arquitetura multiagente, os papéis principais são o orquestrador, o agente supervisor, os agentes workers e o human-in-the-loop, cada um com responsabilidades distintas. Nem todo fluxo usa todos eles, mas entender cada papel esclarece as decisões de design.
Orquestrador e roteador de intenção: onde a decisão começa
O orquestrador é o componente que recebe a tarefa, identifica a intenção e decide para qual agente ou sequência de agentes encaminhar. Ele pode ser um código determinístico, um agente de linguagem ou uma combinação dos dois.
O roteador de intenção é a parte do orquestrador que classifica a solicitação. Se a classificação for errada, todo o fluxo descarrila, por isso muitos sistemas usam confiança mínima antes de prosseguir.
Agente supervisor e agente worker: hierarquia ou colaboração entre pares?
O agente supervisor coordena outros agentes, enquanto o agente worker executa uma subtarefa específica; a relação pode ser hierárquica ou colaborativa, dependendo do estilo de coordenação. Na hierarquia, o supervisor delega e consolida; na colaboração, os agentes negociam entre si.
A escolha entre hierarquia e colaboração depende da previsibilidade do problema. Processos bem definidos se beneficiam de hierarquia; problemas abertos podem ganhar com colaboração.
Ferramentas, chamada de função e RAG como as mãos do agente
Ferramentas, chamada de função e RAG são os mecanismos que dão ao agente capacidade de agir sobre o mundo e acessar conhecimento externo. Uma ferramenta pode ser uma API, um banco de dados ou um serviço interno; a chamada de função permite ao agente invocar essa ferramenta com parâmetros estruturados.
O RAG acrescenta recuperação de documentos antes da geração, fundamentando a resposta em fontes específicas. Em um fluxo multiagente, cada worker pode ter seu próprio conjunto de ferramentas e fontes de RAG, reduzindo a sobrecarga de um agente generalista.
Onde o human-in-the-loop entra sem travar o fluxo inteiro
O human-in-the-loop entra em pontos de decisão crítica ou de revisão, com mecanismos assíncronos que não bloqueiam o restante do fluxo. Por exemplo, um agente pode preparar uma resposta, pausar para aprovação humana e continuar em paralelo outras subtarefas independentes.
A chave é definir gatilhos claros para a intervenção: baixa confiança, risco legal, valor financeiro alto ou primeira ocorrência de um tipo novo de solicitação. Sem esses gatilhos, o humano vira gargalo ou o fluxo nunca pede ajuda.
Os estilos de coordenação mais usados na prática
Os estilos mais usados incluem roteador central, cadeia sequencial, supervisão hierárquica, enxame, paralelismo controlado e avaliação cruzada, cada um com trade-offs específicos. A escolha depende do tipo de tarefa, do volume e da necessidade de controle.
Roteador central: um agente mestre delegando tarefas
No roteador central, um agente mestre classifica a solicitação e delega a um executor especializado, mantendo o controle do fluxo. É o padrão mais simples e mais usado em atendimento com triagem por especialidade.
A vantagem é a previsibilidade; a desvantagem é que o mestre se torna ponto único de falha e pode limitar a escalabilidade se o volume crescer muito.
Cadeia sequencial e pipeline de agentes: a saída de um alimenta o próximo
Na cadeia sequencial, a saída do agente anterior vira entrada do próximo, formando um pipeline com etapas bem definidas. Cada etapa tem um contrato de entrada e saída, o que facilita testes e depuração.
É o padrão típico de produção de conteúdo: pesquisa, redação, revisão. O risco é a degradação de contexto: se um agente omite algo importante, o próximo não tem como recuperar.
Supervisão hierárquica com camadas de coordenação
A supervisão hierárquica organiza os agentes em camadas, onde um agente supervisor coordena subordinados e consolida resultados. O supervisor pode dividir a tarefa em partes, distribuí-las e depois sintetizar a resposta final.
Esse estilo funciona bem quando a tarefa é grande demais para um único agente e exige paralelização com controle de qualidade.
Enxame: agentes pares negociando quem assume cada tarefa
No estilo enxame, agentes pares negociam entre si quem assume cada tarefa, sem um mestre central fixo. A coordenação emerge de regras de leilão, prioridade ou especialidade declarada.
É um estilo poderoso para resiliência, mas difícil de depurar, pois o fluxo de decisão não é linear.
Paralelismo controlado, consolidação e reconciliação de resultados
Paralelismo controlado executa várias subtarefas ao mesmo tempo e depois consolida os resultados, reconciliando divergências. A consolidação pode usar votação, média ponderada ou um agente árbitro.
O controle é essencial para evitar explosão de custos: limitar o número de ramificações e definir o orçamento de tokens antes de iniciar.
Avaliação cruzada e reflexão em ciclo fechado antes da entrega
A avaliação cruzada coloca um agente para revisar a saída de outro, e a reflexão em ciclo fechado permite autocrítica antes da entrega. No ciclo fechado, o agente gera, critica e melhora a própria resposta até atingir um critério de parada.
Esses padrões aumentam a qualidade, mas também o custo e a latência. Devem ser reservados para tarefas de alto risco ou alto valor.
Como o contexto viaja de um agente para outro
O contexto viaja entre agentes por handoff de contexto, estado compartilhado ou memória de agente, com perdas possíveis a cada salto. A escolha do mecanismo impacta diretamente a fidelidade da informação.
Handoff de contexto, estado compartilhado e memória de agente
Handoff de contexto é a passagem explícita de informações relevantes de um agente para o próximo; estado compartilhado é uma área comum acessível a todos; memória de agente persiste informações entre execuções. O handoff é recomendado quando a tarefa é linear e cada agente precisa de um resumo do anterior.
O estado compartilhado funciona para colaboração síncrona, mas exige controle de concorrência. A memória de agente permite que o mesmo agente lembre preferências do usuário entre sessões, mas pode vazar dados se não for segregada.
Degradação de contexto: o que se perde a cada salto
A degradação de contexto é a perda gradual de informações relevantes à medida que o contexto passa por vários agentes, acumulando omissões e distorções. Cada agente pode resumir demais, ignorar nuances ou priorizar errado.
Para mitigar, mantenha um resumo estruturado e não apenas texto corrido; defina que dados são obrigatórios em cada handoff e valide a presença deles antes de prosseguir.
Quando dois agentes discordam: como reconciliar a resposta final
Quando dois agentes discordam, a reconciliação usa votação, avaliação de confiança, escalonamento para humano ou um agente árbitro para decidir a resposta final. O método deve ser definido antes, não improvisado em produção.
Em tarefas de auditoria, por exemplo, a discordância pode ser um sinal valioso de possível erro; nesse caso, escalar para humano é mais seguro do que forçar um consenso artificial.
Quando vale a pena usar vários agentes em vez de um só
Vários agentes valem a pena quando a tarefa exige especialidades distintas, paralelismo ou verificação independente, e o custo adicional de coordenação é compensado pela qualidade ou velocidade. Caso contrário, um agente único com boas ferramentas resolve com menos complexidade.
Sinais de que um agente generalista já estourou o limite
Um agente generalista estourou o limite quando passa a errar em subtarefas específicas, o prompt fica gigante, o consumo de tokens cresce sem melhora e o tempo de resposta degrada. O prompt gigante é um sintoma clássico: tentar ensinar tudo a um único agente torna a instrução confusa e cara.
Outro sinal é a necessidade de ferramentas demais: quando o agente precisa acessar muitos sistemas ou bases de dados diferentes, dividir em especialistas reduz a superfície de erro.
Contraexemplos: situações em que multiagente só adiciona custo e latência
Multiagente só adiciona custo e latência quando a tarefa é linear, o domínio é único, o volume é baixo ou a ambiguidade não existe. Automatizar um processo de um único passo com três agentes é desperdício puro.
Um fluxo de geração de nota fiscal, por exemplo, segue regras determinísticas e não precisa de julgamento probabilístico. Um script bem escrito resolve melhor e mais barato.
Cenários reais no Brasil: atendimento, retaguarda bancária, contratos e auditoria
No Brasil, a orquestração aparece em atendimento com triagem por WhatsApp, retaguarda bancária com conciliação, análise de contratos em etapas e auditoria com verificação cruzada. Cada cenário explora um estilo de coordenação diferente.
O atendimento usa roteador central; a conciliação usa paralelismo controlado; a análise de contratos usa cadeia sequencial; a auditoria usa avaliação cruzada. Todos exigem rastreabilidade para a LGPD.
Perguntas rápidas sobre orquestração agêntica
As dúvidas mais comuns envolvem programação, coordenação e ponto de partida. Responder com clareza ajuda a quebrar a barreira de entrada.
Preciso saber programar para trabalhar com isso?
Não é obrigatório saber programar, mas ter noção de lógica, APIs e custos de execução acelera muito a atuação. Profissionais de produto e design podem contribuir desenhando fluxos, definindo critérios de handoff e avaliando respostas.
Para quem quer ir além da superfície, aprender Python e chamadas de API é o caminho natural.
Quem coordena os agentes: uma pessoa, um código ou um agente supervisor?
A coordenação é feita por código determinístico, um agente supervisor ou uma combinação dos dois, dependendo da arquitetura. Em muitos sistemas, o orquestrador é um código que chama um modelo de linguagem apenas para classificar a intenção.
Um agente supervisor tem mais flexibilidade, mas também mais variabilidade; um código determinístico é previsível, mas menos adaptável.
Dá para começar pequeno, sem montar infraestrutura própria?
Dá para começar pequeno usando plataformas gerenciadas ou frameworks leves, sem montar servidores próprios. O importante é escolher um problema restrito, medir custo e não tentar construir uma plataforma própria no primeiro dia.
Eu confesso que já subestimei a camada de coordenação. Quando comecei a testar agentes, achava que o difícil era o prompt certo. Depois de ver um fluxo simples estourar o orçamento em uma tarde, percebi que o verdadeiro desafio é o que acontece entre um agente e outro. A cola invisível é onde o projeto morre.
Essa percepção mudou a forma como desenho qualquer solução. Hoje, antes de adicionar um agente, pergunto qual é o contrato de entrada e saída, qual o limite de custo por execução e onde o humano entra. Sem essas respostas, o fluxo é apenas uma demonstração bonita. E é exatamente sobre esses pontos que ninguém fala que vamos conversar agora.
O custo invisível: por que fluxos com muitos agentes ficam caros e lentos
Fluxos com muitos agentes ficam caros e lentos porque cada salto entre eles consome tokens adicionais, acumula latência e gera retentativas que dobram o consumo sem entregar resultado melhor. A coordenação em si tem um preço, e ele cresce linearmente com o número de passos.
Como estimar consumo de tokens e latência antes de subir para produção
Estimar consumo de tokens e latência exige medir cada chamada de agente, cada ida à ferramenta e cada retentativa em um ambiente de teste controlado. Comece com um único cenário, rode dez vezes e calcule a média e o pior caso.
Não confie em estimativas de papel. A variabilidade é alta: um agente pode resumir em dez tokens ou em quinhentos, dependendo do prompt e da temperatura.
Limite de custo por execução: cortar antes de a conta chegar
Definir um limite de custo por execução é interromper o fluxo quando o gasto ultrapassa um teto, evitando prejuízo silencioso. O teto deve ser uma decisão de produto, não uma variável técnica solta.
Em muitos frameworks, é possível configurar um orçamento máximo de tokens e uma política de falha. Use isso desde o primeiro dia.
Por que boa parte dos projetos agênticos morre antes da produção
Muitos projetos morrem antes da produção por custo crescente, valor pouco claro e controles de risco frágeis, exatamente o que a observabilidade evitaria. A promessa de automação inteligente esbarra na realidade de latência e gasto imprevisível.
Equipes que não medem o custo por tarefa concluída não conseguem justificar o investimento quando a conta chega. A orquestração precisa nascer com métricas de negócio, não apenas técnicas.
Laço infinito, resposta divergente e outros modos de falha
Os modos de falha mais comuns são laço infinito, resposta divergente, chamada de ferramenta errada e degradação de contexto, todos exigindo mecanismos de contenção. Sem eles, um fluxo pode consumir recursos indefinidamente ou entregar uma resposta incorreta com confiança.
Como travar um agente preso em loop de execução
Travar um agente preso em loop exige limite de iterações, detecção de repetição de estado e timeout rígido. Se o agente repetir a mesma chamada de função com os mesmos parâmetros, corte imediatamente.
O laço infinito geralmente surge quando o agente acha que precisa de mais dados e fica requisitando a mesma coisa. Uma política simples: máximo de três tentativas para a mesma ferramenta, depois falhe ou escale para humano.
Política de retentativa, timeout e degradação graciosa
Política de retentativa define quantas vezes tentar de novo; timeout interrompe espera; degradação graciosa entrega um resultado parcial ou explica a falha. A degradação graciosa é o que separa um sistema robusto de um frágil.
Se um agente de resumo falhar, o fluxo pode entregar os dados brutos com uma mensagem de erro amigável, em vez de travar a fila inteira.
Guardrails que barram a ação em vez de apenas avisar
Guardrails eficazes bloqueiam a ação antes que ela aconteça, em vez de apenas registrar um aviso depois. Por exemplo, um guardrail pode impedir o envio de um e-mail para um domínio fora da lista permitida.
Guardrails pós-ação são úteis para auditoria, mas não evitam o dano. Em fluxos com acesso a dado pessoal ou ação financeira, o bloqueio prévio é obrigatório.
Observabilidade de agentes: rastrear cada passo de decisão
Observabilidade de agentes é registrar cada passo de decisão, chamada de ferramenta e troca de contexto para depurar, auditar e melhorar o sistema. Sem isso, quando algo der errado, você não terá como descobrir o porquê.
Rastreamento de execução: o que registrar e por que isso importa
Registrar a entrada, a decisão do orquestrador, as chamadas de função, as respostas e os erros de cada agente permite reconstruir qualquer execução. Inclua timestamps, IDs de sessão e versões de prompt.
Esse registro é a base para análise de custo, identificação de gargalos e resposta a incidentes. Também serve como evidência em auditorias de conformidade.
Como medir se o sistema multiagente está realmente melhor que antes
Medir melhoria exige comparar o sistema multiagente com a abordagem anterior em métricas de qualidade, tempo de resolução e custo por tarefa concluída. Defina um conjunto de casos de teste representativos e rode os dois lados.
Não caia na armadilha de comparar apenas tempo de execução: a qualidade pode ter caído, e isso custa caro em retrabalho.
Ferramentas de avaliação e comparação entre execuções
Ferramentas de avaliação permitem rodar o mesmo cenário várias vezes, comparar saídas e medir variabilidade e taxa de sucesso. A avaliação deve ser automatizada, não feita manualmente por um humano olhando a tela.
Use métricas como precisão, recall, similaridade e nota de um avaliador independente. Sem avaliação, você nunca saberá se uma mudança no prompt melhorou ou piorou o sistema.
LGPD e rastreabilidade: quando compliance vira decisão de arquitetura
A LGPD deixa de ser um capítulo de conformidade no fim do projeto e passa a ser decisão de arquitetura quando dados pessoais circulam entre agentes. A rastreabilidade exigida pela lei deve ser construída dentro do fluxo, não anexada depois.
Dado pessoal circulando entre agentes: riscos concretos
Dados pessoais circulando entre agentes criam risco de vazamento, uso indevido e perda de controle sobre a finalidade, exigindo minimização e segregação. Cada agente deve receber apenas o mínimo necessário para sua tarefa.
Em um fluxo de análise de crédito, o agente de consulta ao SPC não precisa do e-mail do cliente; o agente de comunicação precisa apenas do e-mail, não do score completo. Essa separação reduz a superfície de exposição.
Registrar decisões de agente para auditoria e defesa jurídica
Registrar decisões de agente com trilha de auditoria permite demonstrar conformidade e responder a requisições de titulares. O registro deve incluir quem acessou qual dado, com qual finalidade e por quanto tempo.
Isso não é burocracia: é a evidência que protege a empresa em caso de questionamento pelo titular ou pela autoridade nacional.
Segregação de memória e identidade por agente
Segregar memória e identidade por agente reduz o escopo de exposição e limita quem acessa o quê dentro do fluxo. Cada agente deve ter suas próprias credenciais e seu próprio armazenamento de memória, sem compartilhamento desnecessário.
Essa prática também simplifica a revogação de acesso e a auditoria, pois o rastro fica mais claro.
Protocolos abertos e runtimes gerenciados: o que mudou na interoperabilidade
Protocolos abertos padronizaram a conexão entre agentes e ferramentas, e runtimes gerenciados em nuvem trouxeram memória de sessão e identidade por agente, reduzindo o trabalho de cola. Essa mudança acelerou a adoção, mas também criou novas decisões de arquitetura.
Interoperabilidade entre agentes e ferramentas sem integração sob medida
Interoperabilidade aberta significa que um agente pode chamar qualquer ferramenta compatível sem código de integração customizado. Isso elimina o trabalho de cola entre fornecedores e permite trocar componentes com menos atrito.
A desvantagem é a dependência de padrões emergentes, que ainda estão em evolução. Escolher um protocolo aberto é uma aposta de longo prazo.
Memória de sessão e identidade por agente direto na nuvem
Runtimes gerenciados oferecem memória de sessão e identidade por agente como serviço, evitando que cada equipe monte infraestrutura própria. Isso reduz o tempo de lançamento, mas aumenta a dependência do provedor.
Avalie se os dados de memória podem ser exportados e se o provedor atende aos requisitos de residência de dados da LGPD.
Orquestração híbrida: determinístico no código, ambíguo no agente
Orquestração híbrida mantém partes determinísticas em código tradicional e entrega apenas o julgamento ambíguo aos agentes, reduzindo custo e risco. Esse padrão é o mais sensato para a maioria dos problemas reais.
Um fluxo de reembolso pode ter regras fixas para valores abaixo de um limite e acionar um agente apenas para casos duvidosos, mantendo o custo médio baixo.
Frameworks, SDKs e plataformas: como escolher sem se amarrar a um fornecedor
A escolha entre frameworks, SDKs e plataformas deve seguir o tipo de problema, o tamanho da equipe e a maturidade de operação, não a popularidade. Não existe bala de prata; existe a ferramenta certa para a dor certa.
Grafos de estado versus papéis e equipes de agentes
Frameworks de grafos de estado modelam o fluxo como estados e transições; frameworks de papéis organizam agentes em equipes com responsabilidades; a escolha depende da previsibilidade do processo. Grafos de estado são melhores para pipelines bem definidos.
Papéis e equipes brilham em tarefas colaborativas com menos linearidade. Se o processo muda muito, papéis oferecem mais flexibilidade.
SDKs oficiais de fornecedor de modelo e o risco de dependência
SDKs oficiais facilitam a integração, mas criam dependência de um fornecedor; abstrações próprias ou protocolos abertos reduzem o aprisionamento. A dependência só é um problema se você não tiver um plano de saída.
Mantenha a lógica de orquestração desacoplada das chamadas diretas ao modelo. Assim, trocar de fornecedor não exige reescrever o fluxo inteiro.
Plataformas de automação com nós de agente e servidores de contexto
Plataformas de automação com nós de agente permitem construir fluxos visuais; servidores de contexto expõem dados e ferramentas de forma padronizada. Essas plataformas reduzem a barreira de entrada para equipes sem muita experiência em código.
O risco é a limitação na customização quando o fluxo cresce além dos blocos pré-definidos. Comece simples, mas saiba quando migrar para código.
Camadas de gateway e controle de tráfego entre agentes
Camadas de gateway centralizam autenticação, rate limiting e políticas de segurança no tráfego entre agentes. Essa camada é essencial quando vários agentes de diferentes equipes ou fornecedores interagem.
Sem um gateway, cada integração repete as mesmas validações e cria brechas de segurança.
Carreira em IA agêntica: o que estudar no Brasil
Para atuar com orquestração de agentes no Brasil, estude fundamentos de programação, chamadas de API, custos de LLM, observabilidade e noções de LGPD. O mercado busca profissionais que consigam ligar a técnica ao valor de negócio.
Habilidades que separam quem monta demo de quem coloca em produção
Colocar em produção exige saber medir custo, tratar falha, versionar prompts, observar execuções e desenhar intervenção humana. A demo impressiona; a produção exige disciplina.
Quem domina essas habilidades consegue entregar sistemas que sobrevivem ao primeiro incidente, e não apenas ao primeiro pitch.
Do RPA ao agente: como reaproveitar experiência em automação
Experiência com RPA ajuda na mentalidade de processos, mas exige migrar de regras fixas para tolerância a ambiguidade e validação de saídas. O profissional de RPA já entende de fluxos, exceções e integração de sistemas.
A diferença é que em RPA você espera o erro para corrigir; em agentes, você projeta para o erro acontecer com frequência e precisar de contenção.
Primeiros passos: montar um piloto de orquestração sem estourar o orçamento
Um piloto enxuto começa com dois agentes, uma tarefa de domínio restrito e métricas de sucesso definidas antes da primeira execução. O objetivo não é impressionar, é aprender sobre custo e comportamento.
Escopo mínimo viável de um fluxo com dois agentes
Um escopo mínimo viável pode ser um agente de pesquisa e um agente de resumo, com orquestrador simples e uma ferramenta de busca. O primeiro extrai informações de documentos; o segundo sintetiza em um parecer curto.
Esse piloto ensina handoff de contexto, limite de custo e observabilidade em escala reduzida.
O que medir nas duas primeiras semanas de teste
Nas duas primeiras semanas, meça custo por execução, taxa de sucesso, tempo total e número de intervenções humanas. Essas quatro métricas contam a história do piloto.
Ajuste o prompt, o limite de tokens e os gatilhos de intervenção a cada ciclo. Ao final, você terá dados para decidir se vale a pena escalar.
Três decisões que colocam a orquestração no lugar certo
Resumo Prático
- 01A Escolha Certa: Antes de qualquer framework, desenhe o quadro de decisão com três variáveis: número de domínios distintos, grau de ambiguidade do julgamento e sensibilidade do dado. Se os domínios forem poucos, a ambiguidade baixa e o dado pouco sensível, um fluxo determinístico ou um agente único resolve com mais economia. Multiagente só faz sentido quando ao menos uma variável exige especialização real.
- 02Ponto de Atenção: A coordenação tem custo próprio, e ele cresce a cada salto entre agentes. Não confunda número de agentes com capacidade de entrega: muitas vezes, um agente com boas ferramentas e um prompt enxuto vence um enxame mal calibrado. O token extra e a latência acumulada são invisíveis no demo e insuportáveis em produção.
- 03Na Prática: Comece hoje com um teste controlado: escolha uma tarefa do seu trabalho que envolva pesquisa e síntese, monte um fluxo com dois agentes usando uma plataforma gerenciada, defina um orçamento máximo de tokens por execução e registre cada chamada. Meça custo, taxa de sucesso e intervenções humanas por duas semanas. Os números dirão se vale a pena escalar.
O quadro de decisão acima não é teoria: é a forma mais barata de evitar o erro clássico de adotar multiagente por modismo. Cruzando domínios, ambiguidade e sensibilidade, você descobre que dois dos três caminhos costumam ser mais baratos de manter do que o terceiro. E quase sempre o terceiro não é o que sua intuição escolheu no início.
Orquestração de agentes não é uma moda passageira, mas também não é a resposta para todos os problemas de automação. É uma camada de engenharia que exige maturidade de observação, controle de custo e respeito à privacidade. Quem entende isso está um passo à frente da maioria que apenas segue tutorial de framework.
A ação prática imediata é simples: pegue um processo real da sua rotina, desenhe o fluxo em papel e pergunte onde está a ambiguidade. Se não houver ambiguidade, não use agentes. Se houver, comece com um agente único e avalie. Só adicione o segundo agente quando o primeiro estourar um limite claro.
O caminho não é linear, mas é navegável. E a primeira decisão de arquitetura que você toma é justamente a mais econômica: saber quando não usar multiagente.
O que pouca gente sabe: A decisão mais econômica em orquestração de agentes é, muitas vezes, não usar vários agentes. Um fluxo determinístico bem desenhado ou um agente único com boas ferramentas resolve a maioria dos problemas do dia a dia com menos custo, menos latência e menos risco de falha. O multiagente brilha em nichos específicos, não como padrão geral.
