
O documento interno que virou prompt na ferramenta de fora já tomou uma decisão pela empresa. Você pode não ter assinado nada, mas o dado cruzou a fronteira. A partir daí, a pergunta deixa de ser se a IA deve ser usada e passa a ser onde cada frase é processada.
O medo de gastar demais trava muita iniciativa antes da primeira reunião. Só que o custo invisível de continuar enviando contratos e laudos para APIs públicas costuma ser maior do que o investimento em um ambiente fechado. A conta não aparece só em reais. Aparece em risco jurídico, perda de controle e dependência de fornecedor.
Muita gente acha que rodar um modelo de linguagem internamente é projeto de data center gigante. Não é bem assim. A decisão tem camadas, e cada uma pode ser resolvida por partes. É isso que você precisa enxergar antes de escolher qualquer hardware.
- Inferência privada de LLM é a execução de um modelo de linguagem dentro de infraestrutura controlada pela própria empresa, sem que prompts, contexto ou respostas atravessem o perímetro.
- O gargalo da adoção corporativa de IA deslocou-se do treinamento para a inferência, elevando a relevância de otimização de GPU, KV cache e gerenciamento de filas.
- Modelos de 7 bilhões de parâmetros em FP16 exigem cerca de 14 GB de VRAM, enquanto versões de 70 bilhões passam de 140 GB; o KV cache pode adicionar mais de 4 GB para contextos de 8 mil tokens.
- Servidores com 4 a 8 GPUs requerem circuitos elétricos entre 30 e 60 kVA e refrigeração dedicada, o que deve entrar no orçamento desde o início.
- A conformidade com a LGPD não é automática: exige logs de auditoria, mascaramento de prompts, retenção controlada e evidências de que o dado não saiu do perímetro.
- Como a arquitetura em camadas separa gateway, serving, dados e observabilidade para manter o controle.
- Os números de VRAM, KV cache e energia que definem se o projeto cabe na sua infraestrutura atual.
- Por que computação confidencial e ambiente air-gapped deixaram de ser excentricidade de banco.
- Quando faz sentido manter tudo on-premises, ir para nuvem privada ou misturar os dois sem abrir mão da soberania.
O que ninguém te contou sobre rodar IA dentro de casa
O entusiasmo com IA generativa esconde uma mudança silenciosa. A discussão deixou de ser qual modelo responde melhor e virou quem controla o caminho entre a pergunta e a resposta. Quando o fluxo é público, cada token vira um ativo que a empresa não enxerga mais. Quando é privado, a responsabilidade se inverte: você passa a responder por acessos, retenção e versão de cada requisição.
Eu costumo ver essa inversão com frequência: o time compra a placa e depois descobre que o problema era o fluxo do dado.
Existe uma camada de projeto que quase ninguém documenta. Não é o servidor, não é a conta em nuvem. É o inventário de onde cada dado pode aparecer. Quem já mapeou um fluxo de atendimento ao cliente descobre rapidamente que a IA não começa no prompt. Começa no banco de conhecimento, na política de acesso e na trilha de logs que ainda não existe.
Antes de olhar preço de GPU, desenhe o perímetro de dados. Decida o que nunca pode sair da empresa. Isso muda tudo o que vem depois.
Inferência privada de LLM: o que é e por que sua empresa precisa entender agora
Inferência de LLM é o momento em que o modelo recebe um prompt, processa o contexto e gera a próxima palavra, repetindo essa operação até completar a resposta. Quando isso acontece em servidores da própria empresa, em uma VPC dedicada ou em ambiente com computação confidencial, falamos de inferência privada.
É uma decisão que eu vejo muitos times adiando até acontecer um incidente.
O termo corporativo adiciona um compromisso: a organização passa a controlar acesso, versão do modelo, retenção de logs e roteamento de cada requisição. Não é apenas uma escolha técnica. É uma declaração de soberania sobre o dado.
Inferência versus treinamento: onde o gargalo realmente está
Treinar um modelo é ensinar a rede a prever a próxima palavra ajustando bilhões de pesos com backpropagation. Exige meses, milhares de GPUs e um conjunto de dados gigantesco. Fazer inferência é usar o modelo já treinado para gerar respostas. É multiplicação de matrizes em tempo real, com consumo intenso de memória e largura de banda.
A analogia mais direta: treinar é construir a fábrica; inferir é operar a linha de produção todos os dias. A maioria das empresas nunca vai treinar um LLM do zero. Mas todas as que usam IA em produção vão inferir a cada chamada.
| Aspecto | Treinamento | Inferência |
|---|---|---|
| Custo dominante | GPU por meses | GPU por requisição |
| Memória crítica | Gradientes e estados do otimizador | Pesos e KV cache |
| Latência aceitável | Dias ou semanas | Milissegundos a segundos |
| Exemplo corporativo | Fine-tuning de modelo aberto | Atendimento ao cliente em produção |
O gargalo real mudou. O custo recorrente por token e a pressão por resposta rápida transformaram a inferência no centro do planejamento de infraestrutura.
O perímetro controlado: prompts, contexto e respostas que nunca saem da empresa
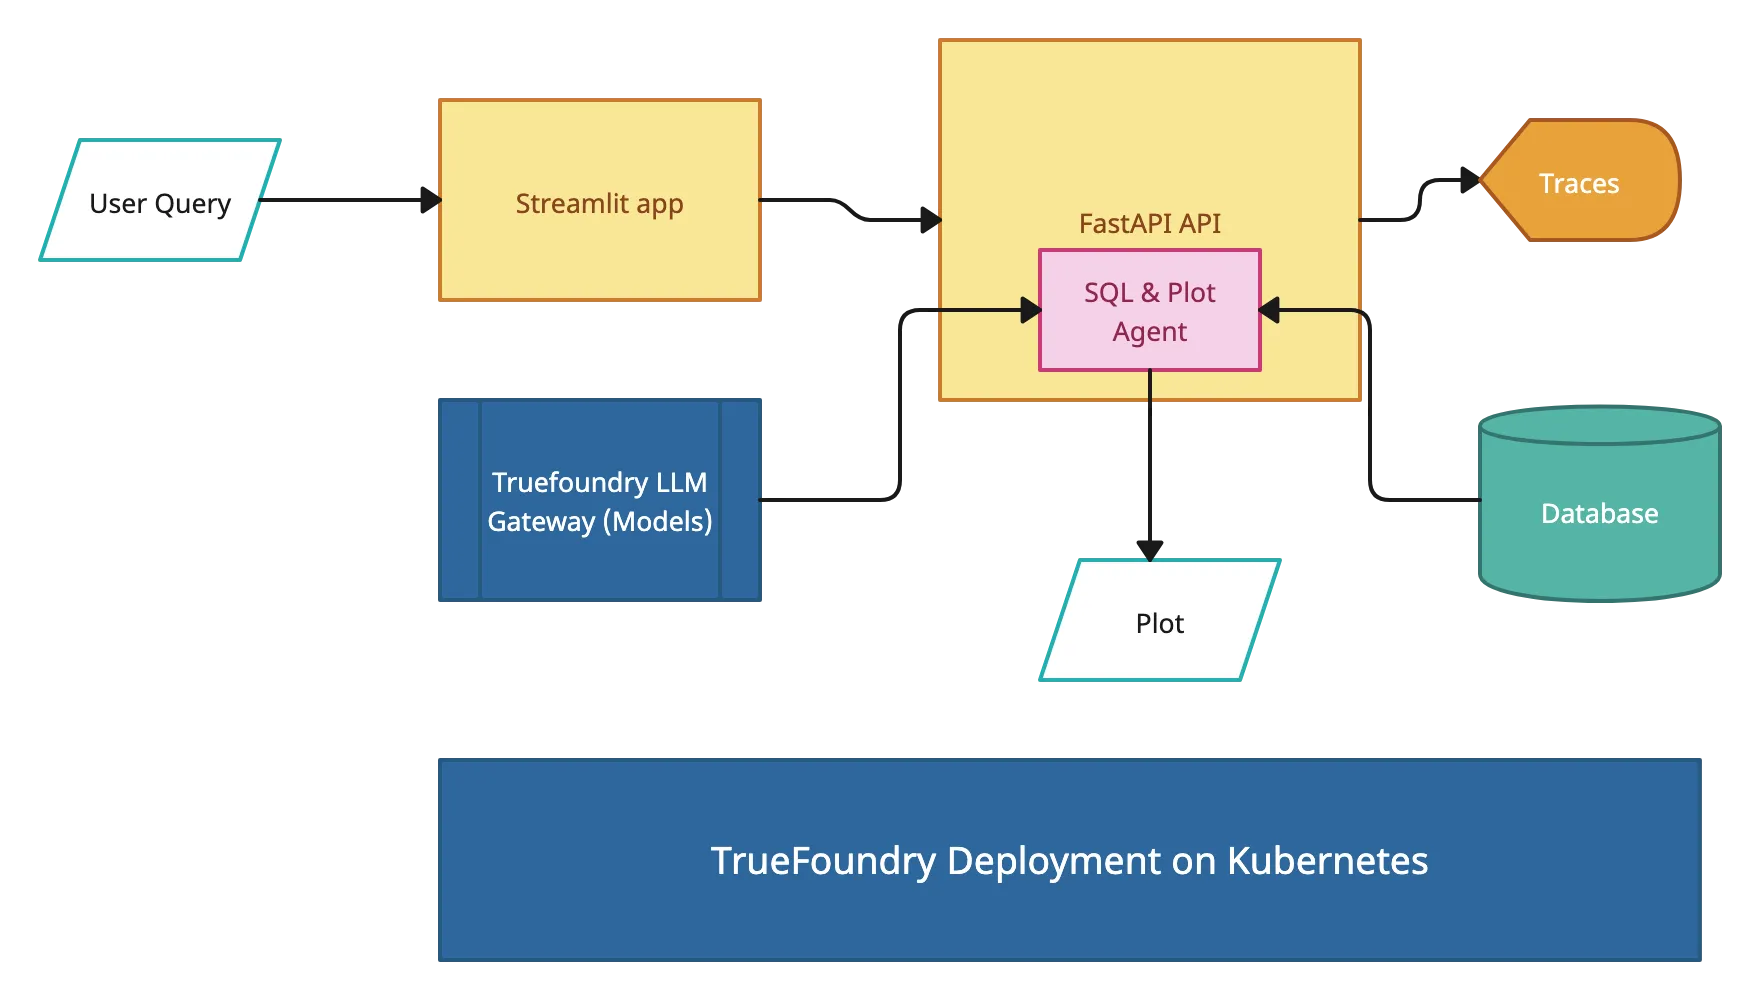
Na inferência privada, prompts, contexto de RAG, cache de atenção e respostas permanecem dentro do perímetro. O modelo pode rodar em servidores próprios, em instâncias dedicadas ou em enclaves de memória cifrada. A escolha do local define o nível de isolamento, mas a regra é a mesma: o dado não atravessa a fronteira sem controle.
Isso permite aplicar políticas de classificação antes do envio, mascarar campos sensíveis e registrar quem acessou o quê. Não é apenas segurança. É capacidade de responder a uma auditoria com evidência, não com promessa.
Como a inferência de LLM funciona por dentro
O processo parece simples: o usuário envia um texto, o modelo devolve uma continuação. Por trás, há uma sequência de transformações que consome memória muito além do tamanho dos pesos.
Tokens, KV cache e o consumo de memória que ninguém vê
Um token é a menor unidade de processamento do modelo, algo entre uma palavra e uma sílaba. Cada token gerado envolve cálculo sobre todos os tokens anteriores. Para não recomputar tudo, o modelo guarda chaves e valores no KV cache. Esse cache cresce com o tamanho do contexto e pode se tornar o maior consumidor de VRAM em cargas longas.
Os números ajudam a dimensionar. Um modelo de 7 bilhões de parâmetros em FP16 ocupa cerca de 14 GB de VRAM. A versão de 70 bilhões passa de 140 GB só de pesos. O KV cache em FP16 de um 7B consome aproximadamente 0,5 MB por token, o que significa mais de 4 GB para um contexto de 8 mil tokens.
| Modelo | VRAM aproximada (FP16) | Exemplo de KV cache |
|---|---|---|
| 7 bilhões de parâmetros | 14 GB | 4 GB para 8 mil tokens |
| 70 bilhões de parâmetros | 140 GB ou mais | proporcionalmente maior |
Ignorar o KV cache é o erro clássico de quem compra GPU pela tabela de preço e descobre estouro de memória em produção.
Continuous batching e PagedAttention: as técnicas que dobram a eficiência
Uma GPU não pode ficar esperando uma sequência terminar antes de começar outra. O continuous batching permite agrupar requisições em diferentes estágios de geração no mesmo lote, aproveitando melhor os núcleos de computação. O PagedAttention organiza o KV cache em páginas, evitando fragmentação e permitindo reaproveitar memória entre requisições com prefixos em comum.
Motores de serving modernos incorporam essas técnicas por padrão. É por isso que a escolha do software de serving muda mais o desempenho do que trocar de GPU em muitos cenários.
Não escolha o serving pelo benchmark do fornecedor. Teste com os seus prompts reais e a sua distribuição de tokens de saída. É ali que o desempenho se revela.
Quantização FP8 e INT4: o que muda na prática
Quantização reduz a precisão numérica dos pesos para diminuir consumo de VRAM e acelerar o cálculo. FP8 mantém uma representação de ponto flutuante reduzida, com perda mínima em muitas tarefas. INT4 comprime drasticamente, mas pode degradar respostas complexas e exigir calibração cuidadosa.
A escolha é um trade-off entre qualidade, latência e custo de infraestrutura. Em fluxos de atendimento com respostas curtas, INT4 costuma ser aceitável. Em análise jurídica ou médica, FP8 ou FP16 é mais prudente.
Arquitetura em camadas para um ambiente de inferência privada
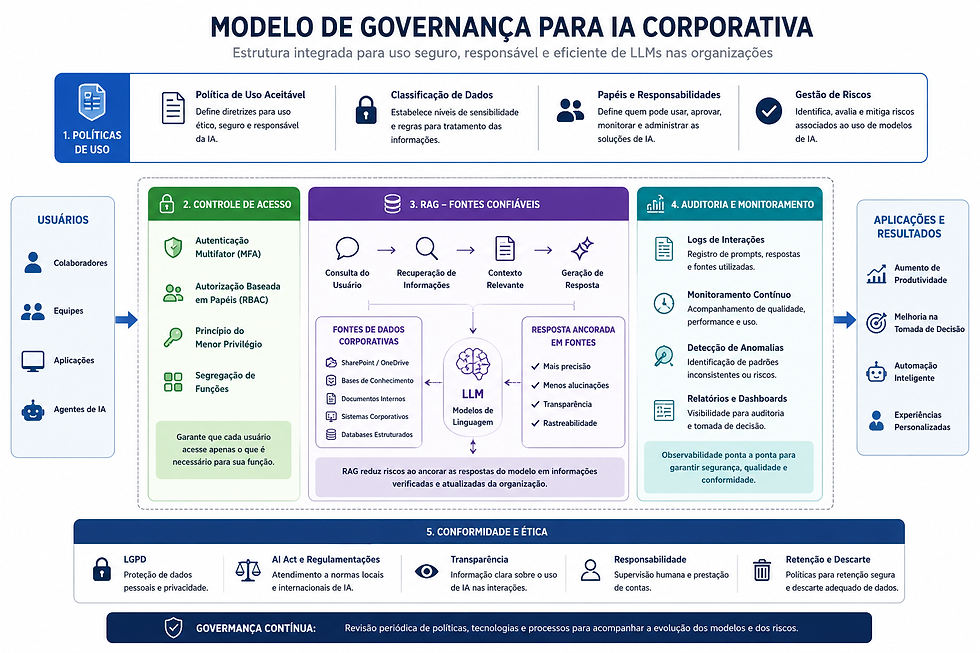
Um ambiente robusto não é só o modelo. É um conjunto de camadas que controlam o fluxo do prompt até a resposta.
As camadas principais incluem gateway, serving, RAG e observabilidade. O gateway, por ser central nas políticas de credenciais, cotas e auditoria, ganha uma seção dedicada mais adiante. Aqui, o foco está nas camadas que dão vida ao modelo dentro do perímetro. Eu prefiro desenhar essas camadas no quadro antes de qualquer pedido de compra.
RAG privado e banco vetorial: como conectar o modelo à base interna
RAG envolve buscar documentos relevantes em um banco vetorial interno e incluir esses trechos no contexto do modelo. O modelo não é retreinado. Ele apenas recebe evidências selecionadas para responder com base no conhecimento da empresa. Se a busca e o banco estão dentro do perímetro, o dado interno não sai.
Um banco vetorial bem indexado reduz alucinações em perguntas sobre procedimentos internos e permite citar a fonte exata de cada resposta.
Observabilidade e logs de auditoria: a base para conformidade
Sem logs, não há como provar que um prompt contendo dado pessoal não saiu da empresa. A observabilidade de LLM coleta métricas como TTFT, tokens por segundo, uso de VRAM e taxa de erro, enquanto os logs de auditoria registram usuário, horário, modelo e conteúdo classificado. A retenção deve seguir política definida, não padrão de fornecedor.
Essas trilhas são a evidência que o DPO e o regulador vão pedir. Sem elas, mesmo uma infraestrutura privada se torna indefensável.
Requisitos de infraestrutura: GPU, VRAM, energia e refrigeração
O dimensionamento começa pela memória da GPU, mas termina na tomada e no ar-condicionado. Quem esquece essa segunda parte descobre o custo invisível tarde demais.
Esse é o ponto que eu mais repito em reuniões de viabilidade: o custo elétrico não é detalhe.
Quanta VRAM um modelo de 7B ou 70B exige?
Já vimos os números: 14 GB para um 7B em FP16, mais de 140 GB para um 70B. Na prática, é preciso somar o KV cache e a folga para concorrência. Um servidor com uma GPU de 24 GB pode rodar um 7B com contexto moderado, mas vai sofrer com várias requisições simultâneas. Para um 70B, são necessárias ao menos duas GPUs de 80 GB ou quatro de 48 GB.
A recomendação é nunca dimensionar para o mínimo. Reserve memória para picos e para futuras versões do modelo.
Consumo elétrico e refrigeração: o custo invisível de um cluster de GPU
Servidores com 4 a 8 GPUs pedem circuitos elétricos na casa de 30 a 60 kVA. Não é plugar na parede. A maioria dos escritórios brasileiros tem infraestrutura elétrica para uma fração disso. Além da energia, a dissipação de calor exige refrigeração dedicada, muitas vezes com corredor quente e frio ou precisão de temperatura.
Antes de fechar qualquer compra, o checklist físico inclui kVA disponível, espaço em rack, capacidade de refrigeração e link redundante.
Latência de rede: por que a localização geográfica do servidor importa
A latência entre São Paulo e a região Leste dos Estados Unidos fica entre 110 e 130 ms de ida e volta. Para uma conversa com IA, isso compromete a experiência. Cada token gerado precisa viajar de volta ao usuário, e atrasos acumulados quebram a sensação de fluidez.
Servidores no Brasil ou em regiões próximas reduzem essa latência e ainda atendem a exigências de residência de dados.
Computação confidencial: quando o nível máximo de isolamento se justifica
Em alguns setores, nem o administrador do servidor pode ver o conteúdo do prompt. A computação confidencial resolve isso com criptografia durante o processamento.
TEE em GPU: TDX, SEV-SNP e modos confidenciais
Os trusted execution environments protegem dados em uso, não apenas em repouso. Extensões como TDX e SEV-SNP criam enclaves onde a memória é cifrada e o hipervisor não consegue acessar o conteúdo. GPUs em modo confidencial estendem esse isolamento para pesos e ativações do modelo.
Isso permite rodar inferência com a garantia de que nem a equipe de operação visualiza prompts sensíveis. A atestação remota confirma que o ambiente é íntegro antes de processar qualquer dado.
Ambiente air-gapped: o extremo da inferência privada
Um ambiente air-gapped não tem saída para a internet. Atualizações de modelo e base de conhecimento entram por mídia controlada ou processos manuais. É o padrão para dados classificados, informações privilegiadas e setores com regulamentação severa.
O preço é operacional: todo patch, modelo e documento precisa de um processo de ingresso. Mas para certos fluxos, é a única resposta aceitável.
Conformidade com LGPD, ANPD e normas setoriais
A privacidade da infraestrutura não concede conformidade automaticamente. É preciso demonstrar controles e responsabilidades.
Como comprovar que os dados não saíram do perímetro
A combinação de logs de auditoria, políticas de gateway e mascaramento de prompts cria o rastro necessário. O DPO precisa conseguir mostrar, a qualquer momento, que um dado pessoal não foi transferido para fora. Isso envolve classificação antes do envio, retenção definida e revisão de acessos.
Sem esse conjunto, a empresa fica vulnerável mesmo com o servidor no subsolo.
ISO/IEC 42001 e NIST AI RMF: o que exigir do fornecedor
Exigir evidências de conformidade com esses padrões é mais eficaz do que confiar em promessas de marketing.
Quanto custa inferência privada? Capex versus opex
O custo não é o preço da GPU. É a soma de aquisição, energia, refrigeração, equipe e atualização ao longo do tempo.
Custo por token: API pública versus infraestrutura própria
APIs públicas cobram por token processado, com custo variável e previsível. Infraestrutura própria transforma custo variável em fixo, mas exige volume para diluir. Para uso esporádico, a API costuma vencer. Para fluxos contínuos, o servidor dedicado tende a ficar mais vantajoso a partir de certo volume.
A métrica central é o custo por token, mas sem esquecer o custo de ociosidade quando a GPU fica parada.
O ponto de equilíbrio para justificar um cluster de GPU
O break-even depende de três variáveis: número de tokens processados por mês, preço da API e taxa de utilização do hardware. Um cluster de 4 GPUs só se paga se tiver carga regular de inferência. Fluxos intermitentes muitas vezes justificam nuvem privada sob demanda.
É um cálculo de engenharia financeira, não de intuição. Simule antes de comprar.
Casos de uso por vertical: onde a inferência privada é indispensável
Alguns setores não têm opção. O custo de vazamento supera qualquer economia de API.
Jurídico: revisão de contratos e documentos sigilosos
Escritórios e departamentos jurídicos lidam com cláusulas confidenciais, estratégias de litígio e dados pessoais. Enviar esses documentos para uma API pública é risco inaceitável. O ambiente privado permite revisar, resumir e comparar contratos sem exposição.
Saúde: análise de laudos e prontuários
Prontuários e laudos contêm dados sensíveis com forte proteção regulatória. A inferência privada permite apoiar triagem, busca clínica e geração de resumos sem que o dado saia da instituição. O ganho operacional é imediato e a conformidade é preservada.
Financeiro: informações privilegiadas e dados regulados
Bancos, seguradoras e gestoras lidam com informações que movem mercados e com exigências do Banco Central. O ambiente privado evita dependência de terceiros e mantém o controle sobre quem acessa o quê. Auditoria se torna parte do fluxo, não um relatório posterior.
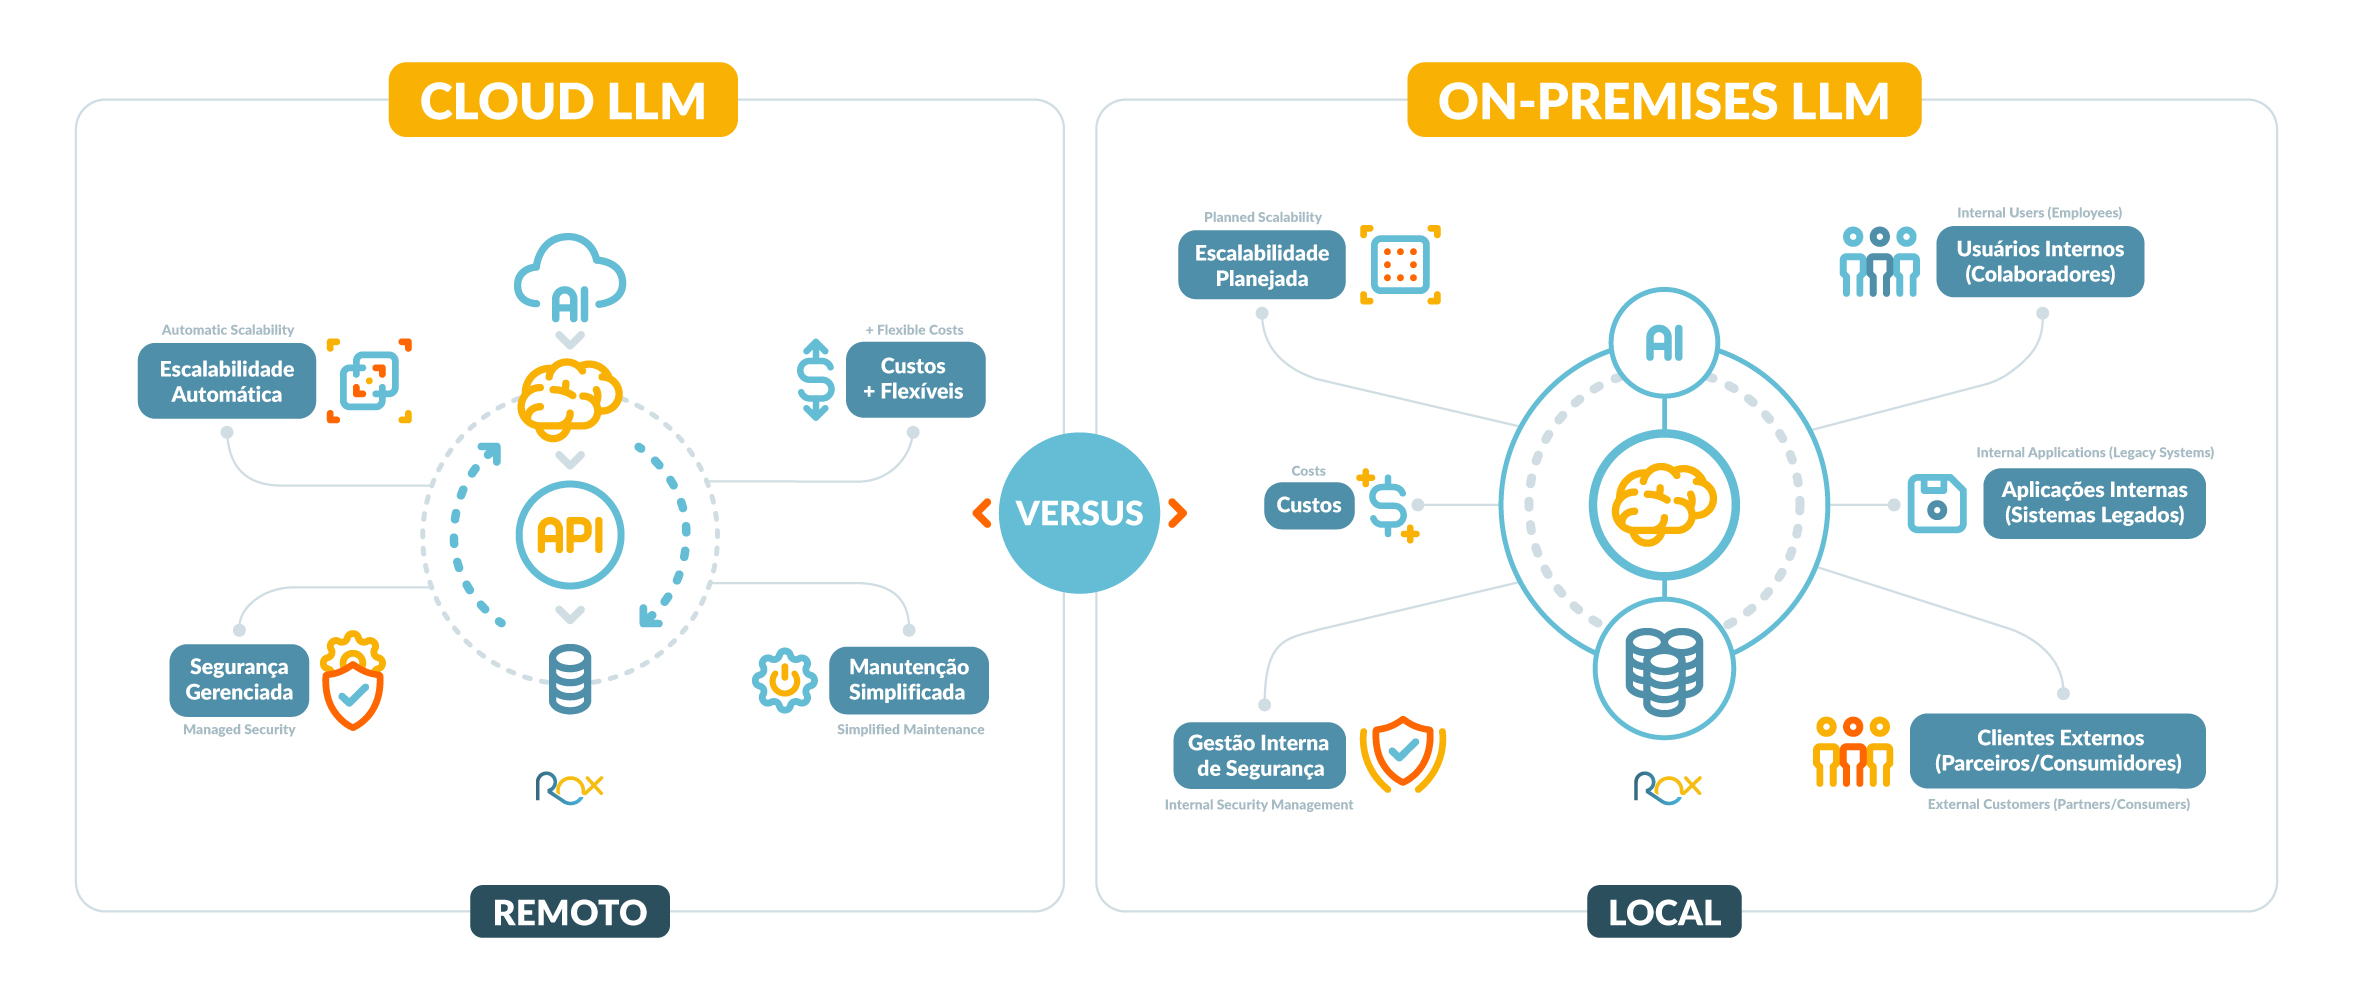
On-premises, nuvem privada ou híbrido: como decidir
Os três modelos existem para resolver situações diferentes. Não há resposta universal.
Roteamento por sensibilidade: a arquitetura híbrida na prática
Na arquitetura híbrida, um gateway classifica o prompt e decide o destino. Dados sensíveis vão para o ambiente privado; fluxos genéricos usam serviço gerenciado. Assim, a empresa equilibra custo, velocidade e conformidade.
Quando um appliance de inferência pronto para rack faz sentido
Times sem equipe para operar cluster de GPU podem adotar appliances pré-configurados. Eles chegam com software, modelo e integrações básicas, reduzindo a complexidade inicial. A limitação é menor flexibilidade para cenários muito específicos.
Perguntas frequentes sobre inferência privada de LLM
Preciso de GPU para rodar um LLM dentro da empresa?
Para produção, sim. CPUs conseguem executar modelos muito pequenos, mas a latência e o throughput são insuficientes para cargas corporativas. Uma GPU de data center é o caminho realista.
Inferência privada resolve sozinha a conformidade com a LGPD?
Não. A privacidade da infraestrutura é necessária, mas não suficiente. É preciso implementar políticas de acesso, mascaramento de prompts, retenção de logs e avaliação de impacto.
Eu vejo um padrão nos times que procuram ajuda. Eles compram a GPU primeiro e só depois descobrem que o problema não era hardware. O problema era saber quais prompts podem sair, quais precisam de mascaramento e quem aprova o acesso. Isso inverte a ordem natural do projeto.
Inferência privada é uma decisão de arquitetura, não de compra. Quando comecei a tratar gateway e logs como pré-requisito, os projetos pararam de travar na aprovação do DPO. O time de segurança deixou de ser obstáculo e virou aliado, porque passou a ter evidência desde o primeiro dia.
É essa mudança de postura que separa o piloto que morre na gaveta do sistema que entra em produção. Agora, o aprofundamento que vai te dar os critérios para não errar nesse caminho.
A corrida pela inferência privada: por que a virada acontece agora
O volume de inferência cresce porque a IA saiu do teste. Empresas deixaram de perguntar se funciona e passaram a operar diariamente. Isso muda o perfil de custo e expõe a fragilidade de depender de APIs externas para dados críticos.
De 23% para 51%: a explosão do uso de IA em produção e o que isso significa
A expectativa de que o uso de IA em produção salte de 23% para 51% em cerca de dois anos aponta para um crescimento agressivo do número de requisições. Cada chamada nova é um token que precisa ser processado. Multiplique isso por milhares de funcionários e a conta por token vira o centro da discussão.
Quem mantém tudo em API pública fica preso a um custo variável que cresce com o sucesso do projeto. Quem possui infraestrutura privada transforma parte desse custo em ativo.
88% das empresas veem IA como motor de competitividade: o papel da inferência privada
A competitividade não vem apenas de usar IA, mas de usá-la com dados que o concorrente não tem. E dados que não podem sair da empresa. A inferência privada permite operar sobre contratos sigilosos, laudos e informações privilegiadas sem abrir mão do diferencial.
Esse número reflete pressão para adotar, mas a adoção sem governança gera risco. O ambiente privado é a resposta a essa tensão.
Modelos de pesos abertos encostaram nos fechados: o que mudou
Modelos de código aberto deixaram de ser brinquedo acadêmico. Em tarefas corporativas, já competem de igual para igual com concorrentes fechados. Para o Brasil, isso é estratégico: soberania e possibilidade de especialização local.
Escolhendo um modelo aberto para português
Avalie a ficha técnica: tamanho em parâmetros, vocabulário de tokenização e desempenho em benchmarks de português. Modelos treinados com dados brasileiros tendem a entender melhor gírias, nomes e contexto local. Teste com o seu tipo de texto antes de decidir.
Fine-tuning com LoRA: modelos pequenos e especializados reduzem custos
Em vez de usar um modelo gigante para tudo, você pode ajustar um modelo menor em uma tarefa específica com LoRA. A técnica congela os pesos principais e treina apenas adaptadores de baixa dimensão. O resultado é um modelo especializado que roda em menos GPUs e com menor custo por token.
Licenciamento de modelos abertos: o que verificar antes de usar
Modelo aberto não significa sem restrição. Alguns proíbem uso comercial, outros exigem atribuição ou impõem limites em setores regulados. Leia a licença com o jurídico e registre a versão exata do modelo usado. Em auditoria, essa é a primeira pergunta.
Gateway corporativo de IA: além do roteamento, o controle de custos e limites
O gateway corporativo de IA não é apenas um reverse proxy de API. É onde a política da empresa vira código.
Como implementar políticas de uso e cotas por time
Defina cotas por departamento, limite de contexto por função e bloqueio de categorias de prompt. Time de marketing não precisa acessar análise financeira. Suporte pode ter limite de tokens por sessão. O gateway aplica isso de forma centralizada, sem depender da boa vontade do usuário.
Integração com DLP e mascaramento de prompts
O gateway precisa conversar com a camada de DLP para bloquear ou mascarar CPF, CNPJ, e-mail e números de contrato antes de chegar ao modelo. O mascaramento pode ser reversível ou irreversível, dependendo da necessidade. Sem essa etapa, a infraestrutura privada não protege contra erro humano.
Mitos e verdades sobre o custo e a operação de inferência privada
A decisão é cercada de suposições que custam caro. Desmontá-las é parte do trabalho.
Hardware fica obsoleto rápido? Estratégias de atualização e financiamento
GPUs evoluem, mas não se tornam inúteis em dois anos. Um servidor bem dimensionado segue produtivo por três a cinco anos em tarefas de inferência. A atualização pode ser gradual, com compra de novos nós e realocação dos antigos para cargas menores. Financiamento via leasing ou parceiros de nuvem privada permite diluir o capex.
Meu time não tem braço para operar cluster de GPU: alternativas gerenciadas
Existe um meio termo entre operar tudo e desistir. Serviços gerenciados de nuvem privada ou appliances pré-configurados entregam o ambiente pronto, com atualizações e monitoramento. O time interno foca na aplicação, não no driver da GPU.
On-premises é seguro só por estar dentro do prédio? Os riscos reais
Servidor físico não é sinônimo de segurança. Um rack sem controle de acesso, senha padrão e sem segmentação de rede é mais vulnerável que uma VPC bem configurada. Segurança exige criptografia em repouso, atualização contínua e trilha de acessos administrativos.
| Mito | Realidade |
|---|---|
| On-premises é sempre mais seguro | Depende dos controles aplicados |
| Nuvem privada é cara demais | Pode ser opex previsível e escalável |
| Hardware fica obsoleto em um ano | Inferência mantém utilidade por vários anos |
| Qualquer modelo aberto serve para tudo | Tarefa complexa exige modelo maior ou ajuste fino |
Como medir o desempenho do seu modelo privado
Velocidade não é percepção. É métrica.
TTFT e tokens por segundo: as métricas que importam
TTFT mede o tempo até o primeiro token aparecer. Tokens por segundo indicam a velocidade de geração após o início. Uma boa experiência conversacional exige TTFT baixo, abaixo de algumas centenas de milissegundos, e vazão suficiente para o usuário não esperar.
Monitore essas métricas por modelo e por tipo de prompt. Latência de rede e tamanho de contexto afetam ambas.
Benchmarks práticos para avaliar qualidade em português
Não confie apenas em benchmarks genéricos. Crie um conjunto de 50 a 100 prompts reais da sua área, com respostas de referência e avaliação humana. Meça acurácia, fidelidade a fontes internas e fluência em português. Esse trabalho é contínuo e deve alimentar a escolha do modelo.
Segurança em profundidade: proteja o modelo, os dados e o perímetro
Uma camada não protege tudo. É preciso defesa em profundidade.
- Proteja os pesos do modelo em repositório privado com controle de acesso.
- Criptografe dados em repouso e em trânsito.
- Segmente a rede entre zona de inferência e zona de usuários.
- Aplique autenticação forte e revisão periódica de acessos.
- Mantenha logs imutáveis e auditoria independente.
O elo mais fraco não é a GPU. É a estação de trabalho do analista que copia o prompt para um serviço externo sem pensar.
O caminho para tirar a inferência privada do papel
Na Prática · O Que Fica
- 01A Escolha Certa: Comece pelo gateway e pelo mapa de dados, não pela GPU. O critério que vale é: o que não pode sair da empresa define a arquitetura, não o contrário.
- 02Ponto de Atenção: Muita gente confunde servidor local com conformidade. Sem logs, mascaramento e retenção definida, o servidor no prédio é apenas um risco com endereço físico.
- 03Na Prática: Hoje, mapeie três fluxos internos que usam IA e classifique cada um como crítico, sensível ou genérico. Leve esse mapa para o DPO e defina o perímetro antes de qualquer orçamento.
Uma decisão raramente citada: cruzar volume diário de requisições, sensibilidade do dado e exigência de residência em uma tabela simples. Esse cruzamento, feito antes de qualquer cotação, evita comprar servidor para fluxo intermitente ou colocar contrato sigiloso em nuvem pública. No Brasil, adicione kVA disponível, refrigeração e link redundante ao checklist. E só depois convoque DPO e segurança da informação para validar o desenho.
A sua decisão não precisa ser definitiva hoje. O importante é parar de operar no escuro e ganhar controle sobre onde cada prompt é processado.
Comece pequeno, com um fluxo crítico e um modelo enxuto. Documente, meça e expanda com base em evidência. A infraestrutura cresce com a confiança, não com o orçamento.
O que pouca gente sabe: A maioria das empresas superestima a dificuldade técnica e subestima o desgaste político da aprovação. Resolver primeiro o alinhamento entre TI, jurídico e segurança destrava mais do que comprar a melhor GPU.
