
Você já saiu de uma reunião com a sensação de que qualquer escolha vai custar caro, só que ninguém quis dizer isso em voz alta?
O time tem os dados no bucket. As consultas demoram. Os arquivos estão espalhados. E a pergunta que fica, calada, é: se eu escolher errado, quem paga é a minha arquitetura pelos próximos anos.
Todo mundo opina, ninguém decide. Talvez você já tenha visto formato aberto virar armadilha de fornecedor. A boa notícia é que existe um caminho para decidir sem drama. E ele começa por entender o que está por baixo dos dois nomes que dominam o debate.
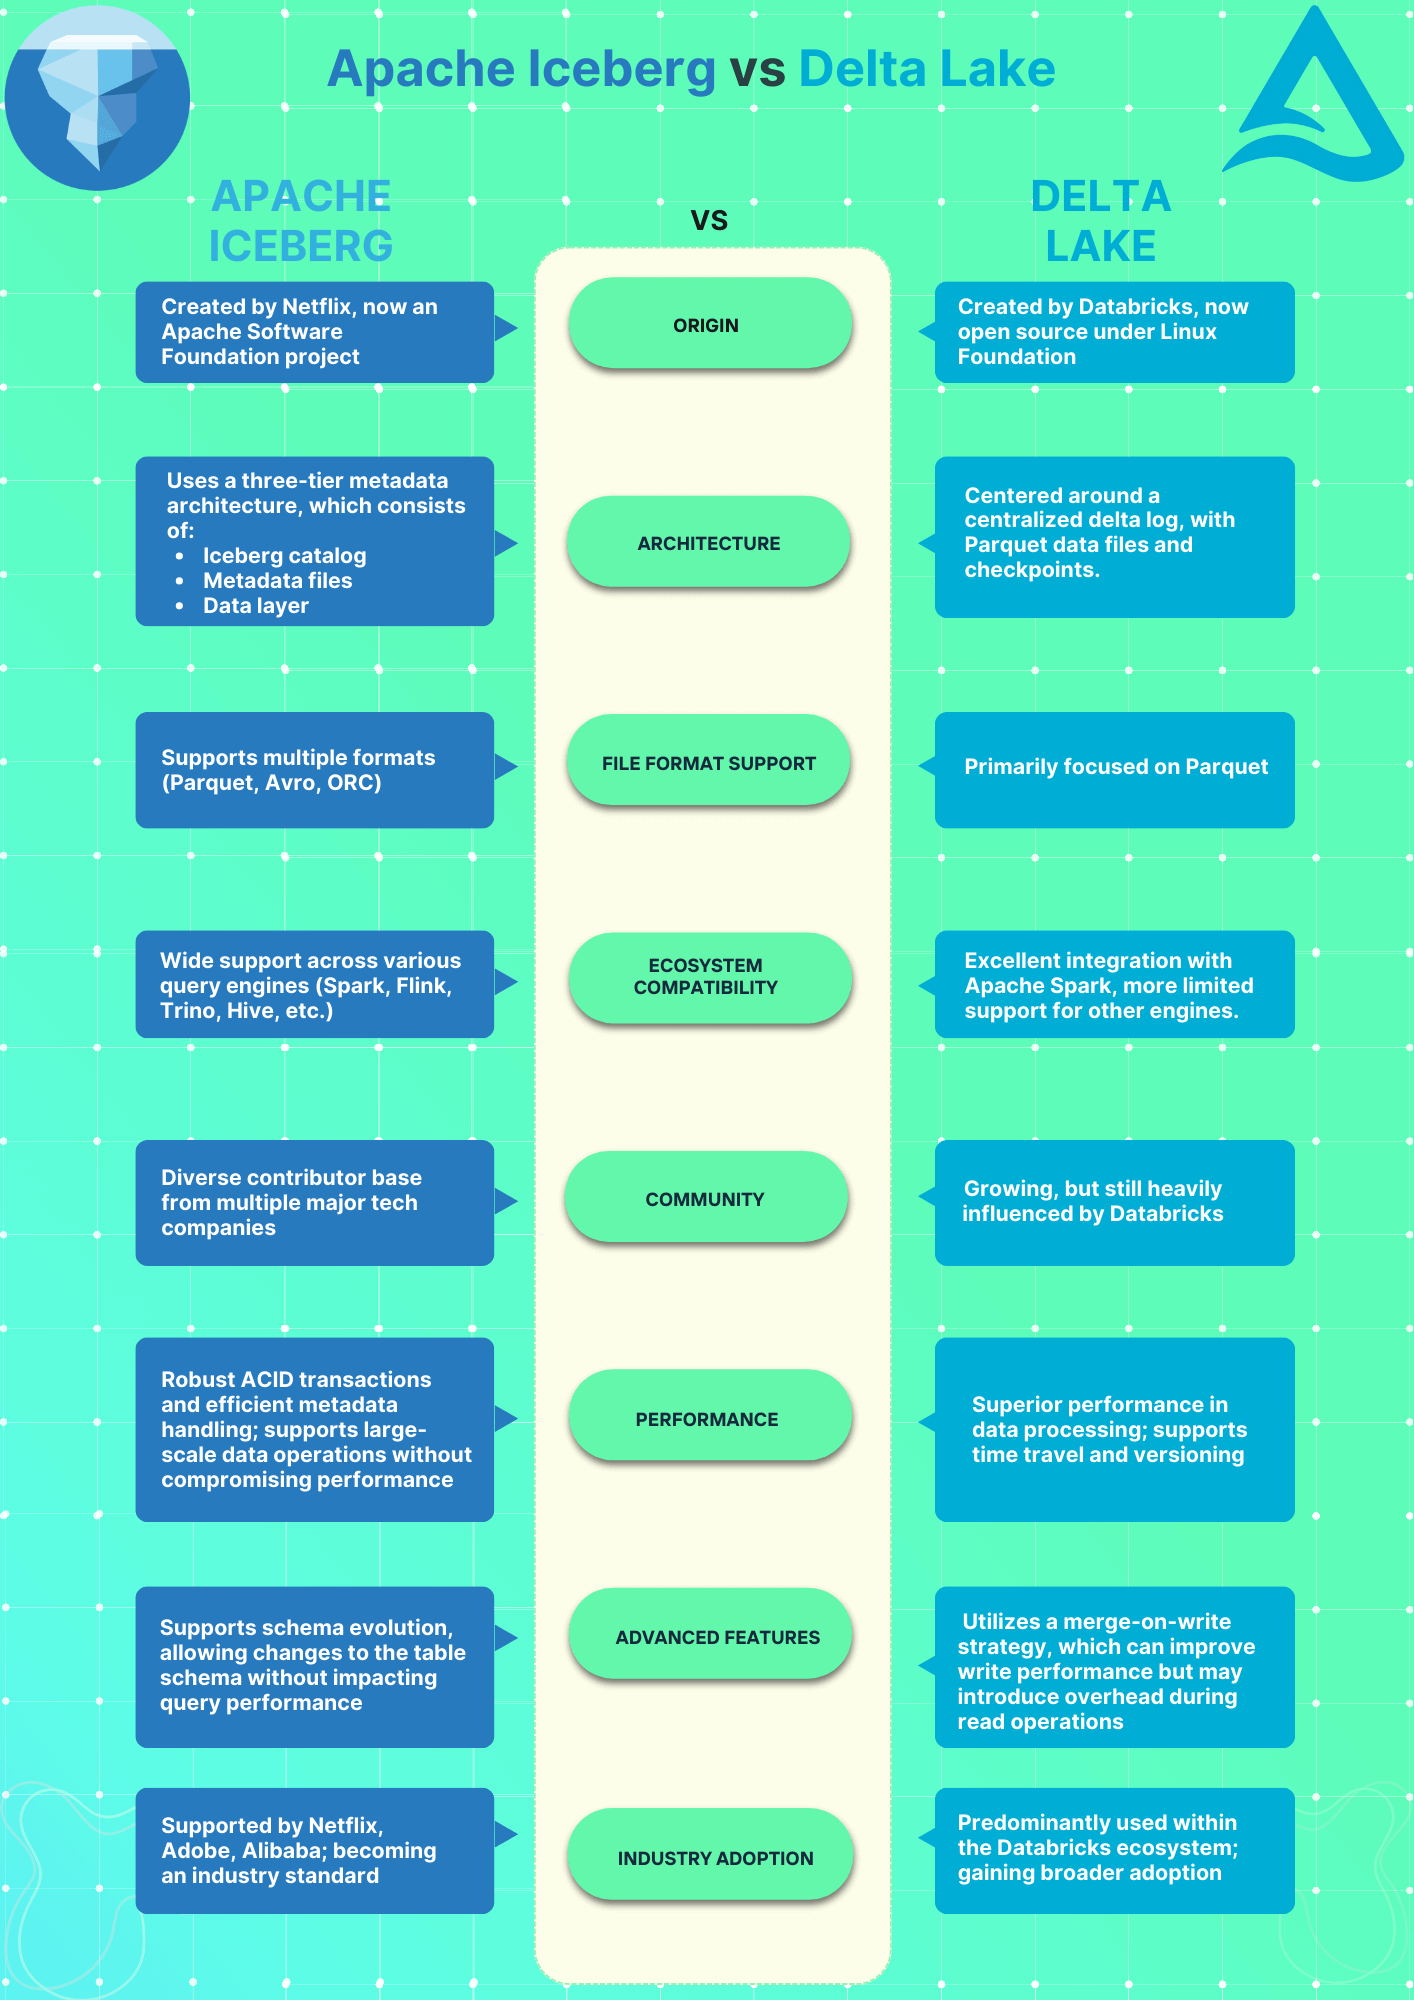
- Delta Lake mantém um log de transações no diretório da tabela com checkpoints periódicos, enquanto Apache Iceberg usa snapshots imutáveis e catálogo para apontar o estado atual.
- Delta Lake nasceu integrado ao Spark e Databricks; Iceberg tem suporte nativo amplo em Trino, Spark, Flink, Snowflake, BigQuery e outros motores.
- O formato de arquivo físico é Parquet na maioria dos casos; Iceberg também aceita ORC e Avro.
- Na escrita, recursos como evolução de partição e merge-on-read diferem; na leitura, a interoperabilidade via Delta UniForm reduz o custo de errar.
- O gargalo operacional raramente é o formato: é a ausência de rotina de compaction, de catálogo governado e de política de retenção de snapshots.
- Por que um monte de Parquet solto no S3 não é uma tabela e onde a decisão de formato realmente trava?
- O que muda se o seu catálogo vale mais que o seu formato?
- Quais são os dois cenários em que escolher Delta Lake é quase obrigatório e os dois em que Iceberg é a saída natural?
- Como usar um plano B de interoperabilidade para não refazer tudo se o time mudar de ideia?
Comparação tem camadas que quase ninguém vê no primeiro slide
Escolher um formato de tabela aberta parece uma decisão técnica. Na prática, é uma decisão sobre confiança, custo e liberdade de movimento.
O time que precisa de transação ACID em cima de Parquet não está comparando dois projetos. Está comparando duas filosofias de metadados, duas formas de lidar com concorrência e dois caminhos de evolução.
O que parece igual na embalagem é completamente diferente quando a consulta demora, o arquivo pequeno multiplica e o fornecedor muda a régua.
Delta Lake vs Apache Iceberg: o que muda quando o data lake ganha transações
Antes de qualquer veredito, a gente precisa de critério. Eu uso o Método dos 3 P’s do Marco: Prioridade de escrita, Portabilidade de leitura e Plano de manutenção. Sem esses três, a escolha vira aposta.
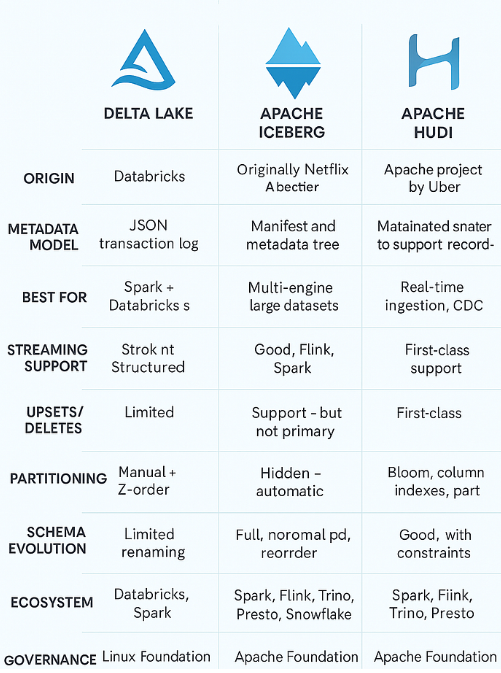
A tabela abaixo resume os pontos que mais pesam na decisão.
| Característica | Delta Lake | Apache Iceberg |
|---|---|---|
| Arquitetura de metadados | Log de transações no diretório _delta_log com checkpoints | Snapshots imutáveis com metadata.json, manifest lists e manifests |
| Catálogo | Implícito no caminho da tabela; integração forte com catálogos do ecossistema Spark | Catálogo externo obrigatório; padrão REST para acesso universal |
| Formato de arquivo | Parquet | Parquet, ORC e Avro |
| Evolução de partição | Historicamente exige reescrita ou overwrite; liquid clustering como alternativa | Partição oculta e evolução sem reescrever dados |
| Deleção em nível de linha | Deletion vectors e Change Data Feed | Position e equality deletes com merge-on-read |
| Streaming/CDC | Integração nativa com Spark Structured Streaming | Suporte via motores compatíveis, dependente do catálogo |
| Ecossistema de motores | Spark e Databricks em primeiro plano; cobertura menor fora desse mundo | Amplo: Spark, Trino, Flink, Snowflake, BigQuery, Athena, StarRocks, DuckDB |
| Compaction/clustering | Liquid clustering e otimização automática em plataformas gerenciadas | Depende de ferramentas externas ou configuração manual |
| Licença de formato | Open source, gratuito | Open source, gratuito |
Por que um monte de Parquet solto no S3 não é uma tabela
Um arquivo Parquet guarda colunas e estatísticas. Ele não guarda a história de mudanças, nem sabe se a leitura está consistente no meio de uma escrita.
Para ter transação ACID, você precisa de uma camada de metadados que diga quais arquivos fazem parte de qual versão da tabela. É exatamente isso que Delta Lake e Apache Iceberg fornecem, cada um à sua maneira.
Duas camadas, dois problemas: arquivos e metadados
Os dados continuam em Parquet, ORC ou Avro. A mágica está na camada de metadados que organiza esses arquivos, controla versões e permite operações como time travel.
Ignorar essa separação é um erro clássico. O gargalo quase nunca está no formato de arquivo, mas na forma como os metadados escalam e são consultados.
Arquitetura de metadados: transaction log de um lado, snapshots do outro
_delta_log, checkpoints e por que o Delta não relê o histórico inteiro
O Delta grava cada operação como um arquivo JSON no diretório _delta_log. A cada 10 commits, o sistema gera um checkpoint com um snapshot consolidado em Parquet.
Isso permite reconstruir o estado da tabela lendo poucos arquivos, sem percorrer o histórico completo. A concorrência otimista usa o log como fonte da verdade.
metadata.json, manifest lists e manifests: o encadeamento do Iceberg
O Iceberg cria um metadata.json por commit. Esse arquivo aponta para uma lista de manifestos, que por sua vez apontam para os arquivos de dados.
Cada commit gera um novo snapshot imutável. O catálogo mantém o ponteiro para o snapshot atual, permitindo branching, tagging e rollback granular.
Quem guarda o ponteiro para a versão atual da tabela
No Delta, a referência da tabela está no caminho do _delta_log. No Iceberg, o catálogo externo guarda a localização do metadata.json vigente.
Essa diferença parece pequena, mas muda a governança: um catálogo de Iceberg pode gerenciar múltiplas tabelas e formatos sob a mesma política de permissão.
Sobre custo de metadados: o Iceberg tende a gerar mais arquivos de metadados por snapshot, mas a leitura é distribuída; o Delta concentra o log, o que pode gerar gargalo em commits muito frequentes. O ponto não é qual gasta menos, mas qual padrão de carga o time opera.
Transações ACID e concorrência: como cada formato evita leitura suja
Commits atômicos e isolamento serializável no Delta Lake
O Delta Lake usa commit atômico baseado em operações de rename ou put-if-absent no object storage. Isso garante que uma versão só aparece após todos os arquivos de dados estarem visíveis.
Leitores nunca veem um estado intermediário. O isolamento serializável é possível porque cada commit carrega a versão anterior do log.
Controle de concorrência otimista e conflitos de escrita no Iceberg
O Iceberg assume que conflitos são raros. Cada escritor gera seu metadata.json e tenta publicar o ponteiro. Se outro commit entrou antes, o escritor precisa reiniciar a operação.
Mecanismos de retry e merge de arquivos ajudam a reduzir falhas, mas em cenários de escrita concorrente intensa o Delta costuma ter vantagem por causa do log serializado.
O que acontece quando dois jobs gravam na mesma partição
No Delta, a concorrência otimista serializa commits. O segundo job recebe um conflito e precisa resolver. No Iceberg, a validação de snapshots geralmente rejeita a modificação baseada em uma versão antiga.
Na prática, com partições bem distribuídas e jobs independentes, os dois funcionam. O problema aparece em pipelines de CDC com muitos commits pequenos.
Evolução de schema e de partição sem reescrever a tabela
Schema evolution: adicionar, renomear e remover colunas com segurança
Ambos suportam evolução de schema como metadados, sem reescrever arquivos. No Delta, a mudança é registrada no transaction log. No Iceberg, o snapshot carrega o novo schema.
Renomear colunas pode quebrar consultas que usam nomes antigos, então exige planejamento. Remover colunas é simples: os arquivos antigos continuam com a coluna, mas ela fica oculta.
Partição oculta e partition evolution no Iceberg na prática
O Iceberg separa a coluna de particionamento da coluna física. Você particiona por mês extraído de uma coluna de data, sem criar uma coluna month= direto no dado.
Assim, mudar o esquema de particionamento não exige reescrever nada. O manifest passa a agrupar os arquivos pela nova regra, e consultas antigas ainda funcionam por causa da evolução de partição.
Por que o Delta dependia de overwrite para mudar o particionamento
Historicamente, o Delta amarrava a partição à estrutura de diretório. Mudar a partição exigia reescrever a tabela ou usar estratégias de overwrite dinâmico.
Com o liquid clustering, o Delta oferece um caminho sem reescrita total, mas a flexibilidade do Iceberg na evolução de particionamento continua sendo um diferencial.
Atualizações e deleções frequentes: deletion vectors contra merge-on-read
Deletion vectors e Change Data Feed: o custo real de reescrever arquivos
No Delta Lake, uma deleção sem deletion vectors reescreve o arquivo inteiro. Com deletion vectors, o sistema grava apenas um vetor com as posições das linhas removidas, adiando a reescrita.
Isso reduz a latência e o custo de escrita para workloads com muitas mudanças pontuais. O Change Data Feed registra as mudanças para consumo incremental.
Position e equality deletes no Iceberg: quando o merge-on-read compensa
O Iceberg usa arquivos de posição (position deletes) ou igualdade (equality deletes) para marcar linhas removidas sem reescrever o Parquet. A leitura concatena os arquivos e aplica os deletes na hora do merge-on-read.
Para atualizações esporádicas, o custo é baixo. Para consultas frequentes, a presença de muitos arquivos de deletes pode degradar a leitura até que uma compaction seja executada.
Qual dos dois lida melhor com CDC em streaming
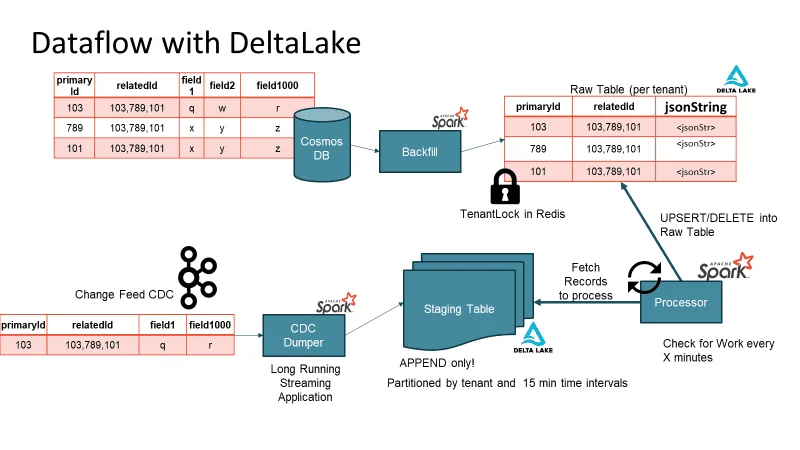
Em streaming com CDC, o Delta se beneficia da integração nativa com Spark Structured Streaming e do Change Data Feed. O Iceberg tem suporte a delete files e merge-on-read, mas a latência depende do motor.
Se o pipeline já roda em Spark e a empresa não tem restrição de fornecedor, o Delta tende a ser mais direto. Em arquiteturas multi-motor, o Iceberg oferece mais portabilidade.
Desempenho em consultas: file skipping, planejamento e o mito do ‘formato mais rápido’
Data skipping por estatísticas: min/max, nulos e bloom filters
Ambos os formatos gravam estatísticas de min/max e contagem de nulos para permitir file skipping. O Iceberg adiciona suporte a Bloom filters em especificações mais recentes.
A eficiência depende da ordenação dos dados. Sem ordenação, as estatísticas são inúteis e o motor lê muito mais arquivos que o necessário.
Small files problem: o gargalo que nenhum dos dois formatos resolve sozinho
Um lakehouse com milhões de arquivos pequenos torna o planejamento de consulta lento, independentemente do formato. A listagem no object storage pode dominar o custo.
A solução é rotina de compaction. Em plataformas gerenciadas, isso é automático; em ambientes do zero, exige scripts e monitoramento.
Quanto o catálogo influencia no tempo de planejamento da query
O catálogo guarda a localização dos metadados e pode fornecer índices. Um catálogo unificado com cache reduz o tempo de planejamento em tabelas com muitos snapshots.
Sem catálogo, o motor depende de caminhos estáticos ou metastore lento. A escolha do catálogo é muitas vezes mais impactante que a escolha do formato.
Ecossistema de motores: onde cada formato realmente funciona
Delta: força no Spark e no Databricks, cobertura menor fora desse mundo
O Delta nasceu dentro do Apache Spark e da plataforma Databricks. A integração nativa garante recursos como otimização automática e liquid clustering no ambiente Spark.
Fora do Spark, o suporte existe, mas nem todos os motores implementam a mesma profundidade de funcionalidades. A experiência pode variar em Trino ou Flink.
Iceberg: Spark, Trino, Flink, Snowflake, BigQuery, Athena, StarRocks e DuckDB
O Iceberg foi desenhado para ser independente de motor. Catálogos REST e especificações abertas permitem que praticamente qualquer mecanismo de consulta leia e escreva tabelas Iceberg.
Para times que usam múltiplos motores, essa portabilidade evita reescrita de dados e reduz o acoplamento a uma única plataforma.
A regra do motor nativo: recurso só existe de verdade em quem escreve
Se o motor de escrita for o Spark, o Delta terá o melhor suporte. Se for Trino ou Flink, o Iceberg costuma estar anos à frente na implementação nativa.
Não adianta escolher um formato porque ele tem uma feature no roadmap do outro motor. A regra é: quem grava, manda.
Catálogo: a decisão que pesa mais do que o próprio formato
Hive Metastore, AWS Glue, Unity Catalog, Nessie, Polaris e Iceberg REST
Hive Metastore e AWS Glue são comuns em ambientes legados. Catálogos unificados como Unity Catalog e Polaris tratam permissões e governança centralizadas.
O Iceberg REST padroniza a interface de catálogo, permitindo que um mesmo catálogo sirva múltiplos motores sem acoplamento. O Delta pode ser governado por catálogos que entendem seu log, mas a integração é mais profunda no ambiente Databricks.
Lock-in de catálogo versus lock-in de formato: qual risco é maior
Trocar de formato pode exigir reescrever metadados. Trocar de catálogo, se ele centralizar permissões e linhagem, pode ser muito mais doloroso.
Por isso, a decisão de catálogo deve vir antes da decisão de formato. Um catálogo que gerencia os dois formatos reduz o risco de ficar preso.
Então, qual escolher? Veredito por cenário de uso
Time pequeno montando o lakehouse do zero
Se o time só conhece Spark e não tem plataforma gerenciada, Delta Lake é a escolha mais produtiva. A documentação é farta, a integração é nativa e a manutenção é direta com Spark.
Se o time já usa Trino ou pretende ser multi-motor, Iceberg pode evitar migração futura. O custo inicial de aprendizado é compensado pela flexibilidade.
Quem já vive no Databricks: mudar gera ganho ou retrabalho?
Dentro do Databricks, o Delta Lake é otimizado de forma nativa. Migrar para Iceberg pode gerar retrabalho sem ganho real, a menos que haja necessidade de portabilidade externa.
Nesse caso, o Delta UniForm permite expor metadados Iceberg sem migrar, servindo de plano B para leitura por outros motores.
Arquitetura multi-motor com Trino, Spark e Snowflake
Para quem consulta com Trino, grava com Spark e às vezes usa Snowflake, o Iceberg é a escolha natural. A independência de motor reduz fricção.
O custo operacional de manter catálogo e compaction é menor do que manter dois formatos ou um formato mal suportado por um dos motores.
Ambiente com exigência de portabilidade entre nuvens
Se a empresa pode trocar de provedor de nuvem, o Iceberg oferece mais garantias de portabilidade por causa da especificação aberta e do catálogo REST.
O Delta, com UniForm, melhora a leitura, mas a escrita ainda depende mais do ecossistema Spark/Databricks. Portabilidade total exige planejamento de catálogo.
Eu confesso que já me vi paralisado entre dois caminhos tecnicamente corretos. No fim, o que destravou a decisão não foi mais benchmark. Foi entender que a pergunta errada é ‘qual é o melhor formato?’. A pergunta certa é ‘qual é o menor custo de saída para o meu time?’.
Quando a gente compara Delta Lake e Apache Iceberg, a resposta muda se o time escreve com um motor só ou se ele precisa de leitura por vários motores. O medo de errar vem de já ter visto projeto parado por dependência de fornecedor. A boa notícia é que a interoperabilidade atual reduziu esse risco. Dá para adotar um formato e ainda expor metadados para o outro.
A seguir, vou aprofundar os critérios que mais pesam depois da comparação técnica. É aqui que a escolha vira roteiro.
UniForm: quando o Delta grava metadados Iceberg de graça
Como funciona na prática e o que ele não resolve
Uma funcionalidade do Delta permite gerar metadados de outro formato sobre os mesmos arquivos Parquet. Isso é feito automaticamente em muitos pipelines.
Ela resolve a leitura por motores que não entendem o log do Delta. Não resolve escrita concorrente nem recursos avançados de evolução de partição do outro formato.
UniForm substitui migrar para Iceberg?
Não. Para leitura, sim. Para escrita e operação, continua sendo Delta. Se o requisito é gravar com motores não compatíveis nativamente, a migração real ainda faz sentido.
Operação no dia a dia: compaction, vacuum e clustering
A rotina mínima de compaction para não dobrar o custo de listagem
Sem uma política periódica de agregação de arquivos pequenos, o tempo de planejamento cresce, e a conta de listagem no object storage dispara.
A recomendação é monitorar o número médio de arquivos por partição e disparar compaction quando passar de 100 ou 200 arquivos, dependendo do tamanho.
Na minha leitura, essa rotina separa projeto que escala de projeto que vive apagando incêndio.
Liquid clustering e clustering adaptativo: o que mudou recentemente
Novas técnicas de clustering adaptativo reordenam dados sem reescrever a tabela inteira. Isso reduz a necessidade de particionamento manual e melhora o file skipping.
Ainda assim, o clustering não substitui a compaction. Ele reorganiza, mas não elimina arquivos pequenos por si só.
Retenção de snapshots, arquivos órfãos e o custo invisível do time travel
Cada commit cria novos metadados. Sem retenção, o time travel fica caro e o armazenamento cresce com arquivos órfãos.
Defina uma janela de retenção baseada em auditoria e siga uma rotina de limpeza. Snapshot antigo além do necessário é desperdício e risco de vazamento de dados pessoais.
Governança, LGPD e segregação de dados pessoais em lakehouse
Deleção em nível de linha para atender pedidos de titulares
Deleção lógica por vetores ou arquivos de posição permite atender a pedidos de exclusão sem reescrever tudo. A LGPD exige prova de que o dado sumiu, não apenas que não aparece.
Auditoria de deleção deve ser registrada nos metadados. Sem isso, a empresa não consegue demonstrar conformidade.
Catálogos unificados e permissão única sobre tabelas Delta e Iceberg
Um catálogo unificado aplica políticas de acesso no nível de tabela ou coluna, independentemente do formato subjacente.
Isso simplifica a governança e reduz o risco de vazamento por caminho alternativo. A escolha do catálogo é o alicerce.
Custo real: varredura, metadados e a fatura em dólar do time brasileiro
Quanto custa listar milhões de arquivos pequenos no object storage
A listagem em object storage cobra por requisição. Milhões de arquivos pequenos geram milhares de requisições a cada consulta, encarecendo a operação antes de ler um byte.
A rotina de compaction é uma medida de economia dura. Em times brasileiros com orçamento apertado, ignorar isso é jogar dinheiro fora.
Com time brasileiro, eu coloco essa linha no radar desde o primeiro dia; a fatura de listagem costuma surpreender.
Migração de Hive e de Delta para Iceberg sem reescrever dados
O que dá para fazer só com metadados e o que exige rewrite
Herança de tabelas Hive pode ser feita criando um snapshot Iceberg a partir dos arquivos Parquet existentes, sem reescrever dados. O mesmo vale para exportar metadados de Delta para Iceberg via funções de conversão.
Mudanças de particionamento ou de formato de arquivo exigem rewrite. Metadados sozinhos não resolvem se o layout físico está inadequado.
Como validar a migração com time travel e conferência de contagens
Antes de apagar a tabela antiga, compare contagens de linhas e soma de valores entre a origem e o destino. Use time travel para conferir versões históricas.
Essa validação é barata e evita surpresas na produção. Registre os hashes de arquivos para auditoria.
Erros comuns de implantação e como evitá-los
Deixar compaction e vacuum na mão de scripts caseiros
Scripts quebram, esquecem de rodar e ninguém monitora. Em produção, isso vira incidente noturno.
Use ferramentas nativas da plataforma ou agendamento robusto com alertas. O custo de automação é menor que o custo de um lakehouse parado.
Assumir que ‘aberto’ significa ‘sem custo de plataforma’
Formato aberto não elimina a necessidade de catálogo, motor de consulta e armazenamento otimizado. A fatura continua chegando em dólar.
Planeje o orçamento de nuvem incluindo metadados, listagem e processamento de compaction. O ‘grátis’ do formato é só a licença.
O horizonte de curto prazo: a fronteira sumiu na leitura e continua na escrita
Iceberg REST Catalog como interface padrão de mercado
O protocolo REST para catálogo se consolidou. Isso permite que qualquer motor acesse tabelas Iceberg com autenticação e governança consistentes.
A tendência é que catálogos unificados sirvam os dois formatos sob a mesma interface, reduzindo o custo de errar na escolha.
Otimização automática empurrada para dentro da plataforma
Plataformas gerenciadas estão assumindo compaction, clustering e retenção de snapshots automaticamente. O time deixa de operar scripts e passa a configurar políticas.
Para times pequenos, essa é a maior alavanca de produtividade. Para times grandes, é a chance de padronizar sem brigar com ferramentas caseiras.
Checklist de decisão antes de adotar ou trocar o formato
Perguntas sobre motores de escrita, catálogo e orçamento de nuvem
Quem grava? Qual catálogo está disponível? Quanto custa listagem e metadados? Essas três perguntas respondem 80% da decisão.
Se o motor de escrita for único e o catálogo for unificado, a escolha é de preferência operacional. Se houver múltiplos motores, a portabilidade manda.
Sinais de que a troca vai gerar retrabalho sem ganho real
Se o catálogo atual não suporta o formato de destino, se o time não tem rotina de manutenção e se o requisito de portabilidade é apenas hipotético, a troca é desperdício.
Nesses casos, melhore a operação no formato atual. A grama não é mais verde do outro lado; é mais cara.
Como tirar o melhor do formato escolhido na sua rotina
Guia de Decisão · Comparativo
- 01Para quem quer economia: Se o time já grava com Spark e não precisa de múltiplos motores, fique no Delta Lake. Economia de esforço e integração nativa reduzem custo operacional.
- 02Para quem quer qualidade: Se a arquitetura exige leitura por Trino, Flink ou Snowflake, aposte no Apache Iceberg. A portabilidade de leitura é a maior garantia de qualidade de acesso.
- 03O equilíbrio: Use um catálogo unificado que sirva os dois formatos. Adote Delta para escrita no Spark e exponha metadados Iceberg via UniForm. Assim você tem interoperabilidade sem migração completa.
O que ninguém conta na reunião de arquitetura: a decisão entre formatos representa menos de 20% do sucesso do lakehouse. Os outros 80% estão na rotina de compactação, na política de retenção de snapshots e na capacidade de monitorar arquivos órfãos. Sem isso, qualquer formato vira um peso morto em seis meses.
Se você chegou até aqui comparando as entranhas dos dois formatos, sua decisão já é melhor que a da maioria. Você não está escolhendo no escuro.
Pegue o checklist, rode as três perguntas no seu time ainda esta semana. A pior decisão é a que continua pendente. A segunda pior é escolher sem testar o plano B.
O que pouca gente sabe: Um teste em 5 passos que se roda em uma tarde e já derruba a indecisão: identificar o motor de escrita, verificar suporte do catálogo, medir arquivos pequenos, checar automação de manutenção e validar leitura pelo outro formato. Quem roda esse teste enxerga a armadilha antes de assinar contrato.
